Follow my new blog

Montag, 22. Juni 2009

Wartung und Evolvierbarkeit [OOP 2009]

Bei meinen Gedanken über die merkwürdige Plötzlichkeit der Unwartbarkeit habe ich eigentlich meinem Credo zuwidergehandelt. Ich habe von Unwartbarkeit geschrieben, obwohl ich immer wieder sage, es gäbe keine Wartung bei Software.

Es gibt keine Softwarewartung

Dabei bleibe ich auch. Es gibt keine Wartung von Software im üblichen Sinn. Der bezieht sich nämlich auf die Weiterentwicklung nach den ersten Releases. Maschinen können gewartet werden. Software aber nicht, jedenfalls nicht in Bezug auf ihre Funktionalität. Sie enthält keine Teile, die kaputt gehen könnten und die man daher proaktiv austauscht, bevor sie kaputtgehen. Das tut Wartung bei Maschinen.

Wenn eine Maschine kaputt geht, dann wird sie repariert. Um das zu vermeiden, wartet man sie. Man erhält Funktionalität proaktiv. Software hingegen geht nicht kaputt, sondern ist höchstens kaputt - nur man bemerkt es erst später. Ein Bug tritt nicht durch Verschleiß wie bei einer Maschine auf. Reparaturen an Software (bug fixing) beziehen sich also immer auf eine bis dato nur unentdeckte "Kaputtheit". Im Umkehrschluss bedeutet das, Software hat keine Verschleißteile. Also ist Wartung nicht nur unnötig, sondern unsinnig. Funktionalität ist entweder fehlerfrei existent - oder nicht. Software ist insofern binär. Da gibt es keinen schleichenden Übergang, den man mit Wartung verhindern könnte.

Aufmotzen statt warten

Statt von Wartbarkeit spreche ich deshalb lieber von Evolvierbarkeit. Schon allein deshalb, weil in Wartung keine Innovation steckt, keine Weiterentwicklung, sondern nur Erhaltung eines IST-Zustandes.  Software muss gerade deshalb eben nicht wartbar sein, sondern vor allem eines: evolvierbar. Sie muss flexibel sein, sie muss einfach erweiterbar sein. Denn wenn eines gewiss ist bei der Softwareentwicklung, dann ist es der kaum versiegende Anforderungsstrom. Je erfolgreicher eine Software, desto breiter und länger dieser Strom. Das erste Release ist nur der Anfang eines hoffentlich langen Softwarelebens durch viele kleine und große Veränderungen hindurch.

Mit Wartung hat das dann nichts zu tun. Das ist eher Evolution im allgemeinen Sinn des Lateinischen evolvere ("ausrollen, entwickeln, ablaufen"): die Software entwickelt sich weiter, sie rollt und rollt immer weiter... und wird natürlich darin auch irgendwann langsamer. Ihre Lebenszeit durch viele Veränderungen hindurch läuft irgendwann ab. Aber bis dahin... Nein, da wird sie nicht gewartet, sondern aufgemotzt.

Aufmotzen oder Pimping, das sind für mich passende Begriffe für das, was wir mit Software machen. Wir packen immer mehr und mehr in eine Software rein. So, als würden wir ein Auto aufmotzen. Bei "Pimp My Car" sieht das Ergebnis am Ende auch ganz anders aus, als der Hersteller es bei Auslieferung mal gedacht hatte. Genauso ist es mit Software.

Die Frage ist daher, wie einfach der Hersteller es macht, sein Produkt später aufzumotzen. Autohersteller machen sich darüber keine Gedanken. Weil Autos aber keine so komplexen Maschinen sind, kann man sie trotzdem noch recht gut aufmotzen.

Bei Software ist das anders. Wenn wir das Aufmotzen da nicht voraussehen und einplanen, dann wird es schwer. Wie man an vielen Projekten sieht. Evolvierbarkeit bzw. Aufmotzbarkeit ist für mich daher das passende Wort für eine wesentliche Eigenschaft von Software. Und ich glaube, dass wir erst wirklich verlässlich evolvierbare Software herstellen werden, wenn wir den Unterschied zwischen Wartbarkeit und Evolvierbarkeit ganz bewusst wahrnehmen.

Und doch gibt es Softwarewartung

Soweit der Blick auf die Funktionalität von Software. In Bezug auf sie gibt es keine Wartung, kein proaktives Handeln zu ihrer Erhaltung. Wenn der Kunde eine neue Funktionalität möchte, dann wird sie reaktiv eingebaut. Voraussetzung dafür ist Evolvierbarkeit.

Die übliche Wartung sichert proaktiv Funktionalität zu. Allgemeiner formuliert ist Wartung jedoch eine Tätigkeit, die proaktiv irgendeine Qualität erhält. Funktionalität ist nur eine sehr naheliegende Qualität, die sich bei Maschinen mit Wartung erhalten lässt und daher Wartung für Software nahelegt.

Welche anderen Qualitäten hat Software denn aber noch? Vielleicht lässt sich ja der Wartungsbegriff für sie retten. Performance oder Skalierbarkeit oder Sicherheit oder Robustheit sehe ich auf einer Stufe mit Funktionalität. Entweder ist Software so performant oder robust, wie sie sein soll - oder sie ist es nicht. Da gibt es keinen schleichenden Übergang. Bei der Hard-/Software-Infrastruktur mag das anders sein. Dort kann man Teile proaktiv austauschen, um eine Qualität zu erhalten. Das fällt für mich aber unter Administration statt Softwareentwicklung.

Eine andere Qualität jedoch scheint mir durchaus ein Fall für die Wartung. Es ist die Evolvierbarkeit, mit der ich oben die Wartung vom Thron gestoßen habe. Denn eben diese Evolvierbarkeit ist nicht entweder vorhanden oder nicht, sondern verfällt über die Zeit. Sie stellt sich sozusagen durch ihren Zweck selbst ein Bein. Indem sie es leicht machen soll, Software zu verändern, sie wachsen zu lassen, zehrt sie sich selbst auf. Jede funktionale Veränderung von Software lässt ihre Evolvierbarkeit ein kleinwenig erodieren. Evolution verschleißt die Evolierbarkeit.

Wartung auf der Meta-Ebene

Damit ist Evolvierbarkeit selbst ein Kandidat für Wartung. Von der konkreten Funktionalitätsebene wandert Wartung sozusagen auf die Meta-Ebene. Software warten bedeutet also nicht wie bisher, Funktionalität zu erhalten und schon gar nicht, neue Funktionalität herzustellen, sondern die Voraussetzungen für neue Funktionalität zu erhalten.

Softwarewartung ist die Bedingung für die Möglichkeit von Veränderung. Bisher war Softwarewartung eben diese Veränderung selbst. Jetzt ist sie ihre Voraussetzung. Das ist ein Unterschied, finde ich. Ein erheblicher Unterschied.

Clean Code Developer wird damit zu einem Werkzeugkasten für die Softwarewartung. Das hatte ich bisher nicht so gesehen. Eine solche Assoziation fühlte sich falsch an. In Bezug auf den bisherigen, falschen Gebrauch des Begriffs Wartung war sie es auch. Mit der hiesigen neuen Definition jedoch wird die Assoziation korrekt.

So bin ich nun im Reinen mit dem Begriff Wartung. Ich muss nicht länger darauf bestehen, dass es keine Softwarewartung gibt. Sie hat vielmehr eine andere Aufgabe als bisher. Evolvierbarkeit ersetzt nicht Wartbarkeit. Wartbarkeit bezeichnet jetzt nur einen Zustand, in dem Evolvierbarkeit immer wieder leicht herzustellen ist. Wartbarkeit ist sozusagen Meta-Evolvierbarkeit ;-)

Evolution ist die Reaktion auf Veränderungen in der Umwelt. Wartung ist die proaktive Erhaltung von Evolvierbarkeit.

Warum überrascht Unwartbarkeit? [OOP 2009]

Warum sind Projekte immer wieder überrascht, dass sich ihr Code so schlecht warten lässt? Fehler zu beheben wird immer schwieriger. Neue Kundenwünsche einzubauen dauert immer länger. Mir scheint, viele fühlen sich damit so plötzlich konfrontiert wie mit Weihnachten.

image Am Anfang ist diese Situation noch in weiter Ferne; man hat von ihr gehört und will auch rechtzeitig darauf achten. Aber es ist ja noch so lang bis dahin. Dann vergeht die Zeit mit Tagesgeschäftalltagsstress... und - zack! - steht die Unwartbarkeit vor der Tür und man hat eben doch vergessen, sich frühzeitig darum zu kümmern.

Warum ist das so? Immer wieder. Es mangelt ja nicht an Kenntnis, dass es Unwartbarkeit gibt. Irgendwie liegt sie meistens jedoch in der Zukunft und betrifft ohnehin eher die anderen.

Bei Weihnachten rührt die gefühlte Plötzlichkeit des Auftretens sicherlich vom Stellenwert her. Weihnachten ist nicht so wichtig wie die Dinge des Tagesgeschäftes. Außerdem scheinen die Weihnachtseinkäufe so leicht zu erledigen, dass dafür immer noch irgendwie Zeit ist. Das ist ja auch durchaus wahr. Selbst am heiligen Morgen lassen sich noch Geschenke kaufen - und das wird genutzt, wie die vollen Geschäfte zeigen.

In Kauf genommen wird dabei jedoch, dass man dann damit zufrieden sein muss, was noch übrig ist. Die Qualität leidet also darunter, dass Geschenke auch noch bis kurz vor knapp gekauft werden können. Man ist eher bereit, sich mit dem, was übrig ist zufriedenzugeben, als rechtzeitig einzukaufen.

Aber das ist natürlich unkritisch im Verhältnis zu dem, was in Projekten passiert, wenn sie sich von der Unwartbarkeit überraschen lassen. Deshalb lohnt die Frage doppelt, woher denn dort diese Überraschung kommt?

Abgesehen einmal von einer allgemeinen Überschätzung oder gar Überheblichkeit, die das Problem entweder weit in der Zukunft, eher bei anderen oder als eigentlich nicht so schlimm einstuft, scheint mir hier die Natur der Sache der Kern des Problems. Das ist die Struktur von Software. Deren Komplexität macht nämlich die Wart- oder Unwartbarkeit aus.

image Mir scheint nun, dass die Sorglosigkeit um Umgang mit der Wartbarkeit das Ergebnis einer Fehleinschätzung des Wachstums eben dieser Komplexität ist. Ich kann mir die Überraschung über Unwartbarkeit nur vorstellen als Überraschung über ein schnelleres Wachstum als erwartet. Man weiß, dass die Komplexität über die Zeit zunimmt, man weiß, dass damit die Gefahr von Unwartbarkeit droht. Soweit sind sich alle einig. Aber wer im Projekt ist, glaubt daran, dass die Komplexität überschaubar wächst. Dass sich die Unwartbarkeit langsam ankündigt und dann immer noch gegengesteuert werden kann. Und genau das sieht mir wie ein großes Missverständnis aus!


image


Komplexität wächst nicht linear! Doppelt soviel Code bedeutet nicht doppelt soviel Komplexität und damit nur etwas verringerte Wartbarkeit!

Komplexität wächst vielmehr exponenziell! Und damit wächst auch die Unwartbarkeit exponentziell. Das bedeutet, mit der Unwartbarkeit ist es wie mit den Seerosen. Ein Beispiel aus der 10. Klasse: "Wenn die Seerosen auf einem Teich im Verlauf von 3 Monaten (90 Tage) jeden Tag ihre Zahl verdoppeln, wann bedecken sie den Teich zur Hälfte? Nach a) 10 Tagen, b) 45 Tagen, c) 60 Tagen, d) 89 Tagen?"

image Wenn wir die Wartbarkeit von Software mal mit der Schiffbarkeit des Teiches in diesem Beispiel gleichsetzen und Schiffbarkeit (mit Ruderbooten) definieren als "Max. 25% des Teiches sind von Seerosen bedeckt", wann tritt dann Unschiffbarkeit ein? Am 88. Tag. Ganz plötzlich.

Am 87. Tag ist der Teich nur zu einem 1/8 mit Seerosen bedeckt. Am 86. Tag ist es nur 1/16 oder knapp 6% usw. Das heißt, 90% der Zeit von 3 Monaten sind die Seerosen auf dem Teich kaum sichtbar; es sind hübsche Inselchen die weit weniger als 1% der Teichfläche bedecken. Dann jedoch, im Verlauf von 5 Tagen explodiert ihre Zahl. Wer am 87. Tag knapp 10% Bedeckungsfläche wahrnimmt und denkt, man solle gelegentlich mal überlegen, die Seerosen zurückzuschneiden, der muss nur ein Wochenende nicht hinschauen und hat keine Chance mehr zur Reaktion. Dann ist der Teich nämlich plötzlich komplett bedeckt.

Genau so scheint es mir mit der Unwartbarkeit. Man kennt ihre grundsätzliche Möglichkeit (Analogie: man weiß, Seerosen können sich bis zur Unschiffbarkeit ausdehnen), man will auch darauf achten, dass sie nicht eintritt (Analogie: man schaut gelegentlich auf den Teich, was denn die Seerosen so machen) - aber schließlich wird man von ihr überrollt (Analogie: wenn man die Seerosen als signifikante Fläche wahrnimmt, dann ist es schon zu spät).


image 

Das ist ja auch in anderen Bereichen ein oft beobachtetes Verhalten. Vorsorge in der Gesundheit oder im Umgang mit der Umwelt ist schwer "zu verkaufen", weil in beiden Bereichen vieles lange gut geht. Aber wenn es dann schlecht wird, dann oft sehr schnell. Dann kippt das Biotop um, dann ist der Herzinfarkt da - auch wenn kurz vorher noch alles ziemlich in Ordnung schien.

In der Softwareentwicklung liegen die negativen Effekte von mangelnder Vorsorge und Voraussicht jedoch nicht so weit in der Zukunft. Hier reden wir nicht über Jahrzehnte, sondern über wenige Jahre oder gar nur Monate. Da sollte es doch möglich sein, über die Schwierigkeit von uns Menschen, mit exponenziellen Entwicklungen klarzukommen, einfach mal hinwegzuspringen. Im Vergleich zum Weltklima oder der Globalisierung ist doch ein Softwareprojekt eine simple Angelegenheit. Da sollte es uns leicht fallen, Wartbarkeit nicht so auf die leichte Schulter zu nehmen. Lassen wir uns also nicht länger von Unwartbarkeit überraschen. Wenn wir die Plötzlichkeit lieben, haben wir ja auch immer noch Gruselfilme oder Weihnachten ;-)

Samstag, 20. Juni 2009

Wider die Geißeln zukunftsfähiger Software: Abhängigkeiten und Synchronizität

Was macht Software so schwer zu evolvieren? Abhängigkeiten. Was beschränkt den Nutzen morgiger Prozessorgenerationen für heutige Software: Synchronizität.

Funktionseinheiten, die von anderen abhängig sind, die insofern einen bestimmten Kontext voraussetzen, lassen sich mühsamer weiterentwickeln als solche, die frei und unabhängig sind. Möglichkeiten zur Abhängigkeit gibt es natürlich viele und nicht alle lassen sich immer kappen. Aber das Streben nach immer geringerer Kopplung lohnt sich - wenn Evolvierbarkeit gefragt ist. Wo hingegen zweifelsfrei Effizienz nötig ist, da müssen womöglich Kopplungen eng bleiben oder gar enger werden. Im Zweifelsfall bin ich jedoch der Meinung, dass unsere Software heute eher unter zu engen, als zu losen Kopplungen leidet.

Funktionseinheiten, die synchron arbeiten, arbeiten notwendig auch sequenziell. Von einer steigenden Zahl an Prozessorkernen können sie nicht profitieren. Die nützen ja nur, wenn es auch etwas parallel auszuführen gibt.

Abhängigkeiten und Synchronizität stehen uns also im Weg bei unserer Reise in eine glücklichere Softwarezukunft. Was tun? Ich beschreibe mal ein paar Gedanken anhand eines Beispiels. Hier etwas synchroner und abhängiger Code:

class MyBusinessLogik : IBusinessLogik
{
    IDatenquelle dq;
    IDatensenke ds;
    IValidator v;

    public BusinessLogik(IDatenquelle dq, IDatensenke ds, IValidator v)
    {
        this.dq = dq;
        this.ds = ds;
        this.v = v;
    }

    public int Aktualisiere(Parameter p)
    {
        v.Validiere(p);
        Datencontainer dc = this.datenquelle.LadeDaten(p.Query);
        int n = AktualisiereDaten(dc, p.Request);
        this.datensenke.SpeichereDaten(dc);
        return n;
    }

   private int AktualisiereDaten(Datencontainer dc, Aktualisierungsanfrage req) { ... }
}

Statische und dynamische Abhängigkeiten

Der Code ist statisch und dynamisch abhängig von anderen Funktionseinheiten:

image

Diese statischen Abhängigkeiten der Businesslogik sind statisch in der Businesslogik-Implementation verdrahtet. Das ist ein Punkt, den es deutlich herauszustellen gilt. Ausdruck der statischen Abhängigkeiten sind die Felder der Klasse MyBusinessLogik und die Aufrufe von Methoden auf deren Instanzen.

Die dynamischen Abhängigkeiten hingegen, sind nicht in der Businesslogik-Implementation zu finden. Sie kennt nur abstrakte Dienstleister wie IDatenSenke oder IValidator. Die zur Laufzeit relevanten Implementationen, werden ihre hingegen über den Ctor injiziert.

In puncto Abhängigkeiten hat also schon eine gewisse Separation of Concerns (SoC) stattgefunden: die laufzeitrelevante Bindung übernimmt eine andere Codeeinheit.

Vollständig ist die SoC allerdings nicht. Denn - wie gesagt - die BusinessLogik hat neben ihrer funktionalen Aufgabe auch noch eine nicht-funktionale: die statische Bindung. Ihr dienen die Felder und die Aktualisiere()-Methode. Ihre funktionale Aufgabe erfüllt AktualisiereDaten().

Während der Code also durch Injektion konkreter Abhängigkeiten gegenüber der früheren Praktik evolvierbarer geworden ist, weil er nicht mehr an Implementationen gebunden ist. So ist die Kopplung noch nicht wirklich lose. Die statischen Abhängigkeiten halten ihn starr. Das schränkt seine Evolvierbarkeit ein.

Synchronizität und Sequenzialität

Dass die BusinessLogik synchron und sequenziell ist, liegt auf der Hand. Ohne Hilfsmittel kann sie in C# nicht definiert werden. Ein Aufrufer von Aktualisiere() muss also auf das Ergebnis warten. Und während Aktualisiere() läuft, kann ein Prozessor nichts anderes tun; andere Aufgaben, andere Programme müssen auch warten. (Preemptives Multitasking lasse ich hier außen vor. Damit kann zwar doch quasi-parallel weiteres geschehen, aber jede zusätzliche Aufgabe verlangsamt alle schon laufenden.)

Auf innerhalb der BusinessLogik gibt es keine Parallelität. Mehrere Prozessorkerne bringen hier überhaupt keinen Nutzen. Es könnte ja sein, dass Laden, Verarbeiten und Speichern der Daten im Rahmen der Aktualisierung zumindest überlappen dürfen. Während noch Daten geladen werden, kann die Verarbeitung schon beginnen. Und während die Verarbeitung noch läuft, können erste Ergebnisse schon gespeichert werden.

Die synchrone Notation einer Sprache wie C# lässt das jedoch ohne Hilfsmittel nicht zu. Und weil wir letztlich "in C# denken", kommen wir auch nicht so recht auf die Idee, dass es auch anders sein könnte. Die beschränkten Ausdrucksmttel von C# stehen für uns zu sehr im Vordergrund. Das objektorientierte, synchrone Programmierparadigma ist wie ein Korsett um unsere Vorstellungen.

Das schränkt den Nutzen ein, den die Software, zu der die BusinessLogik gehört, aus der zukünftig wachsenden Zahl an Prozessorkernen ziehen kann.

Ausweg Asynchronizität

Ich glaube nun, dass uns ein anderes Paradigma einen Weg aus dieser beschränkten Zukunftsfähigkeit weisen kann. Durch asynchrone Programmstrukturen können wir beide Fliegen mit einer Klappe schlagen. Und das geht so:

1. Abhängigkeiten beseitigen

Im ersten Schritt schütteln wir auch noch die statischen Abhängigkeiten ab. Oder genauer: Wir separieren den Aufbau von Abhängigkeiten komplett von der problemdomänenorientierten Funktionalität. Dazu führe ich mal den Begriff "Prozessdefinition" ein. Ich trenne die Abfolge von Arbeitsschritten ganz klar von den Arbeitsschritten selbst. Alle Arbeitsschritte werden damit frei von Abhängigkeiten:

image

Die BusinessLogik v2 enthält jetzt nur noch die Funktionalität von AktualisiereDaten()! Aufgabe der Prozessdefinition ist es nun, die Arbeitsschritte ohne Abhängigkeiten in eine nützliche Reihenfolge zu bringen. Dass sie selbst viele Abhängigkeiten enthält, ist nicht schlimm. Sie ist im Vergleich zu den Arbeitsschritten trivial.

Dynamische und statische Abhängigkeiten stehen damit auf derselben Stufe: sie sind separierte Concerns.

image

Die Konsequenz solcher Beseitigung von Abhängigkeiten ist, dass Funktionalität nicht mehr geschachtelt ist. Funktionalität der Problemdomäne wie die BusinessLogik oder auch Infrastrukturfunktionalität wie eine Datenquelle sind Blätter im Abhängigkeitsbaum. Ergebnisse reichen sie also nicht tiefer hinunter in einem Aufrufbaum. Unter ihnen gibt es ja keine Ebene mehr. Stattdessen sind Ergebnisse immer Rückgabewerte in irgendeiner Form. Nur wer die Funktionalität aufruf bzw. sie zusammengesteckt hat, weiß ja, was weiter mit Ergebnisse geschehen soll. Die Wiederverwendbarkeit ist damit gestiegen.

2. Vom Callstack zum Fluss

Wenn nun alle Funktionalitäten ohne Abhängigkeiten sind, dann sind wir plötzlich sehr frei, was ihre Verschaltung angeht. Müssen wir sie denn wirklich noch synchron "ineinanderstecken"?

Hier aber zunächst ein erster Schritt. Ich nehme die refaktorisierten Funktionalitäten 1:1 und füge sie zu einem Prozess zusammen. Eine Funktion scheint mir da der passende Ausdruck für einen Prozess. In den geht etwas hinein und am Ende kommt etwas heraus.

class Prozessdefinition
{
    public Func<Parameter, int> Prozess { get; private set; }

    public Prozessdefinition(IDatenquelle dq, IDatensenke ds, IValidator v, IBusinessLogikV2 blv2)
    {
        this.Prozess = new Func<Parameter, int>(p =>
           {
               v.Validiere(p);
               Datencontainer dc = dc.LadeDaten(p.Query);
               int n = blv2.AktualisiereDaten(dc, p.Request);
               ds.SpeichereDaten(dc);
               return n;
           });
    }
}

Soweit das synchrone Programmierparadigma. Um weiter zu kommen, ist nun eine Richtungsänderung nötig. Asynchrones Denken und codieren ist nötig. Dafür zunächst eine etwas andere Darstellung der Funktionseinheiten:

image

Die Funktionseinheiten haben immer noch keine Abhängigkeiten untereinander. Aber es ist ihnen nun deutlich anzusehen, was reingeht und was rauskommt. Eine implementationsunabhängige Darstellung im Sinne von EVA (Eingabe-Verarbeitung-Ausgabe).

Das bisherige Abhängigkeitsdiagramm war nicht so detailliert. Darin war nur zu sehen, ob eine Funktionalität von einer anderen abhängig ist. Indem nun die Funktionalitäten aber darstellen, wie man von ihnen abhängig sein kann, ist Klarheit gewonnen. (Dass ich Ausgaben bei Validator und Datensenke eingeführt habe, ist hier vernachlässigbar. Sie machen den späteren asynchronen Prozess etwas einfacher.)

Die Prozessdefinition ist nun nicht mehr in einer Black Box eingeschlossen, sondern kann im Grunde das trivial gewordene Abhängigkeitsdiagramm ersetzen:

image

Diese Grafik zeigt nicht nur die grundsätzlichen Zusammenhänge der Funktionsbausteine, sondern auch den Zweck, zu dem sie zusammenhängen: die Abarbeitungen eines Prozesses. Und bitte im Hinterkopf behalten: Die Funktionsbausteine haben keine statischen Abhängigkeiten mehr. Ihre dynamische Zusammenarbeit im Prozess sieht man ihnen selbst nicht an. Die ist Sache des Prozesses.

Jetzt der Trick: Wenn der Prozess erstmal so dargestellt ist und eben nicht sofort als Code wie in der obigen ersten Prozessdefinition, dann... ja, dann ist es leicht, von einer synchronen Kopplung abzusehen. Warum sollte ich dies:

image

übersetzen in jenes:

if (v.Validiere(p))
{
    Datencontainer dc = dq.LadeDaten(p.Query);
    ...

Das Prozessdiagramm ist aber nicht zu verwechseln mit einem simplen Flowchart, das auch ein Kind des synchronen Programmierparadigmas ist. Es ist allgemeiner als Fluss zu verstehen: Die Funktionseinheiten sind verbunden zu einem Fluss, auf dem Daten zwischen ihnen als Verarbeitungsstationen fließen.

3. Asynchrone Flüsse

Die Darstellung eines Prozesses bietet nun die Chance, das Paradigma zu wechseln. Die Frage ist nur, wie kann solch bisher synchroner, sequenzieller Code in asynchronen, sequenziellen oder parallelen Code gewandelt werden?

Der Schlüssel liegt in expliziten Verbindungsstücken!

Bei der üblichen synchronen Programmierung sind die Funktionsbausteine quasi aneinandergeschweißt. Die ursprüngliche BusinessLogik war untrennbar verbunden mit einem Validator usw. Sie bildeten eine Einheit - auch wenn die konkreten Abhängigkeiten erst zur Laufzeit dynamisch eingespritzt wurden.

Das ist zwar effizient - aber eben auch inflexibel. Und es ist synchron. Damit steht solche Verschweißung der Evolvierbarkeit im Wege.

Ganz anders das Bild, wenn die Funktionsbausteine nicht verschweißt, sondern verschraubt sind. Mit expliziten Verbindungsstücken - wieder eine Separation of Concerns - können Beziehungen viel flexibler aufgebaut werden.

Ein Mittel dafür sind die Ports der Microsoft Concurrency Coordination Runtime (CCR). Mit ihnen ließe sich ein Prozess ganz anders beschreiben. Aus den bisherigen synchronen Methoden

interface IValidator
{
    bool Validiere(Parameter p);
}

interface IDatenquelle
{
    Datencontainer LadeDaten(string query);
}

könnten solche werden:

void Validiere(Parameter p, Port<bool> output) {...}

void LadeDaten(string query, Port<Datencontainer> output) {...}

Ich habe sie aus zwei Gründen nicht in eine Klasse oder ein Interface eingetragen: Zum einen möchte ich an dieser Stelle keine bestimmte Lösung jenseits explizit verbundener Funktionsbausteine vorschlagen. Auch die CCR Ports sind nur eine mögliche Variante für explizite "Schraubverbindungen". Zum anderen sollen die beiden freigestellten Routinen unterstreichen, dass Funktionale Programmierung - also die Konzentration auf Funktionen statt Klassen - einen Beitrag leisten kann, um Software zukunftsfähig zu machen.

Die Übersetzung einer bisher synchronen Methode könnte mit Ports also geradlinig sein: Eingabeparameter bleiben, Rückgabewerte werden ersetzt durch einen Output-Port. Der ist mit der nächsten Verarbeitungsstation verbunden. Zu jeder Methode gehört also ein Port für die Eingabe. Für die obige Methode Validiere() könnte das in vereinfachter und roher Form so aussehen:

Port<bool> pOutput = ...;

var pValidiere = new Port<Parameter>();
pValidiere.ReceiveSequentially(p => Validiere(p, pOutput));

Der Port für die Ausgabe, der gehört dann zum nächsten Arbeitsschritt im Prozessfluss.

Die Methode ReceiveSequentially() ist eine Extension Method für Ports, die ich mir ausgedacht habe. Sie bindet einen Eventhandler so an einen Port, dass immer nur ein Element zur Zeit verarbeitet wird. Das sichert eine sequenzielle, allerdings asynchrone Verarbeitung durch die Stationen in einem Prozessfluss zu. Bei Bedarf können Stationen aber natürlich auch parallel verarbeiten. Ihre vielen Ergebnisse müssen dann nur auch wieder eingesammelt werden. Map-Reduce ist dafür ein berühmtes Beispiel.

Viel wichtiger als Parallelität ist jedoch die Asynchronizität. Dadurch, dass Arbeitsschritte jetzt explizit über puffernde Ports gekoppelt sind, geben sie immer wieder ihre Prozessorressource (Thread auf einem Kern) frei. Das skaliert wunderbar. Es ist kooperatives Multitasking, das alle Kerne oder potenziell auch viele Maschinen überspannt.

Damit ist das eingangs beschriebene Ziel im Grunde erreicht: Die Abhängigkeiten sind minimiert, der Umgang mit ihnen ist herausfaktorisiert. Und die Asynchronizität ist eingeführt. Damit ist der Code zukunftsfähiger geworden:

  • Viele Flüsse können in dieser Weise gut skalierbar abgehandelt werden und nutzen dabei alle Prozessorkerne. (Und falls es mal nicht viele Flüsse durch die Last auf einem Rechner zu bearbeiten geben sollte, dann zeige ich in einem späteren Blog-Posting, wie so ein unterforderter Rechner anderen seine Leistung anbieten kann.)
  • Abhängigkeitsfreie Funktionseinheiten lassen sich viel einfacher weiterentwickeln und neu kombinieren.
Technische Umsetzung mit Notationsschwierigkeiten

Jetzt aber noch kurz konkret zur Umsetzung des obigen Prozesses:

  • Es kommen Parameter an, die in mehreren sequenziellen Schritten durch einen Prozess laufen sollen.
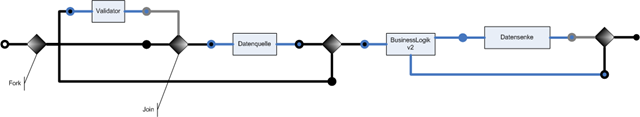
  • Am Anfang werden die Parameter validiert. Nur wenn die Validation erfolgreich ist, werden sie zum Laden von Daten weitergeschickt. Ein Fork-Station spaltet die Daten dafür auf: sie werden gleichzeitig zur Validation und zu zwei Joins weitergeleitet.
  • Der erste Join führt das Ergebnis der Validation und die Query in den Parametern zusammen und leitet die Query weiter an die Datenbeschaffung - aber natürlich nur, wenn die Validation erfolgreich war. Validation und Datenbeschaffung laufen also nicht parallel, sondern immer noch sequenziell.
  • Nach der Datenbeschaffung führt ein weiterer Join deren Ergebnis (Datencontainer) und die Parameter zusammen und leitet beide weiter an die eigentliche Geschäftslogik.
  • Die Geschäftslogik verändert die Daten und reicht sie weiter zum Speichern. Gleichzeitig erzeugt sie ein Ergebnis (z.B. Anzahl veränderter Datensätze), das jedoch nur am Ende aus dem Prozess herauskommt, wenn auch die Datenspeicherung erfolgreich war.

Dieses Szenarion mit Ports zu bauen, ist nicht schwierig. Es ist nur etwas umständlich. Eine wirklich gute textuelle Notation oder ein Fluent Interface, dass gerade diese Fork-Join-Kombinationen plastisch macht, ist mir noch nicht eingefallen.

Ohne Fork-Join oder auch Scatter-Gather oder Select/Choice und andere Muster, bei denen mehrere Ports beteiligt sind, wäre es einfach. Mit Pipes könnte ein vereinfachter Fluss ohne Fork-Join so aussehen:

Validator | Datenquelle | BusinessLogikv2 | Datensenke

Jede Station würde ihre Ergebnisse einfach nur weiterschieben an die nächste. Allerdings müsste z.B. der Validator alle Parameter weitergeben und nicht nur sein boolean-Resultat, weil ja nachfolgende Stationen davon mehr oder weniger für ihre Arbeit brauchen.

Etwas realistischer ließe sich so ein Fluss auch mit einem Fluent Interface beschreiben, z.B.

new Stage<Parameter>(Validiere)
    .Stage<Parameter, Tupel<Datencontainer, Parameter>>(LadeDaten)
    .Stage<Tupel<Datencontainer, Parameter>, Tupel<Datencontainer, int>>(Aktualisieren)
    .Stage<Tupel<Datencontainer, int>, int>(SpeichereDaten);

Dabei stehen die generischen Typparameter von Stage<TIn, TOut> für den Typ des Input- und des Output-Ports. Als Verarbeitungsschritt wird dann Action<TIn, TOut> erwartet.

Die Schwierigkeit der Notation - nicht der Technologie! - beginnt jedoch, wenn Flüsse sich teilen und wieder zusammenfließen.

Die Fork am Anfang des obigen Prozesses ließe sich so formulieren:

var fork = new Fork<Parameter, Parameter, string, Parameter>(
    (i, o0, o1, o2) => {oo.Post(i); o1.Post(i.Query); o2.Post(i);});

Der erste Typparameter definiert den Input-Typ, die weiteren die Typen für die Output-Ports, d.h. die Input-Ports der nachfolgenden Schritte. Die Aufgabe des Lambda-Funktion ist also die Aufspaltung oder Verteilung des Input auf die Outputs.

Die einzelnen Verarbeitungsschritte sind ebenfalls für sich genommen leicht zu formulieren:

var val = new Stage<Parameter, bool>(Validiere);
var laden = new Stage<string, Datencontainer>(LadeDaten);
var akt = new Stage<Tupel<Datencontainer, Parameter>,
                                          Datencontainer, int>(Aktualisieren);
var speichern = new Stage<Tupel<Datencontainer, int>, int>(SpeichereDaten);

Und wie die Joins formulieren, die Zusammenführungen von mehreren Flussarmen?

var joinFürLaden = new Join<bool, string, Datencontainer>((i0, i1, o0) => oo.Post(i1));

var joinFürLogik = new Join<Datencontainer, Parameter, Tupel<Datencontainer, Parameter>>(
    (i0, i1, oo) => oo.Post(new Tupel<Datencontainer, Parameter>(i0, i1)));

var joinFürEnde = new Join<bool, int, int>((i0, i1, oo) => oo.Post(i1));

Zum Schluss noch die Prozessschritte "zusammenstöpseln":

fork.Output[0] = val;
fork.Output[1] = joinFürLaden.Input[1];
fork.Output[2] = joinFürLogik.Input[1];

val.Output = joinFürLaden.Input[0];

joinFürLaden.Output = laden;

laden.Output = joinFürLogik.Input[0];

joinFürLogik.Output = akt;

akt.Output[0] = speichern;
akt.Output[1] = joinFürEnde.Input[1];

speichern.Output = joinFürEnde.Input[0];

Der Input geht dann in den Prozess bei fork.Input hinein und das Ergebnis kommt bei joinFürEnde.Output heraus. Das ist technologisch nicht kompliziert - aber die vorstehende Formulierung ist sicher nicht so gut zu lesen wie die synchrone Variante ganz am Anfang.

Was tun? Hier ist wahrscheinlich eine DSL angezeigt. Eine textuelle könnte schon ein wenig Erleichterung bringen; am Ende geht es aber wohl nicht ohne Diagramme. Ja, das wäre doch mal was: Eine grafische DSL mit einem hübschen Designer, die aus solchen Prozessdiagrammen eine Assembly produziert, die wir nur noch mit Prozessschritten parametrisieren müssen, wenn das nicht schon der Designer getan hat, weil wir ihm Referenzen auf Prozessschritte übergeben haben.

Ist das dann nicht aber die Microsoft Workflow Foundation neu erfunden? Nein. Die Prozesse, von denen ich hier geschrieben habe, sind leichtgewichtiger. Sind sollen nicht lange laufen. WF scheint mir da Overkill.

Und vielleicht... findet sich ja doch auch noch eine textuelle Beschreibung z.B. in Form eines Fluent Interface? Das würde mir sehr gefallen.

Aber all dessen ungeachtet ist mir an dieser Stelle wichtig gezeigt zu haben (oder zumindest laut gedacht zu haben), dass asynchrone explizite Kopplung mit soetwas wie CCR Ports hilft, Software zukunftsfähig in zweierlei Hinsicht zu machen. Wer asynchrone Prozesse denkt, der geht anders mit Abhängigkeiten um und macht Software fit für Mehrkernprozessoren. Da müssen wir gar nicht erst auf Axum & Co warten. Das geht hier und heute.

Dienstag, 16. Juni 2009

Tagesschäft und Lernen vereint - School of .NET

image Neulich haben Stefan Lieser und ich noch in unseren Blogs drüber diskutiert. Jetzt ist sie schon Realität: die School of .NET. Wir fanden das "gebrainstormte" Konzept so überzeugend, dass wir uns gleich hingesetzt und ein Curriculum ausgearbeitet haben.

Wer sich für berufsbegleitendes Lernen interessiert, wer nicht ein oder gar mehrmals 5 Tage am Stück aus dem Betrieb raus kann, um den Clean Code Developer "Kickstart" zu bekommen, wer schon lange sein .NET-Know-How festigen und ausbauen wollte, ohne das Projekt länger zu verlassen, dem eröffnet jetzt die School of .NET die Möglichkeit, das Angenehme mit dem Nützlichen zu verbinden. (Was hier angenehm und was nützlich ist, das Lernen oder das Tagesgeschäft, das überlasse ich jedem selbst zur Bewertung ;-)

Hier die Beschreibung des ersten "Semesters", dass Stefan und ich anbieten: die Ausbildung zum .NET-Entwickler für lokalen, synchronen und sequenziell entwickelten Code, den Synchronous Developer. Es findet simultan in Köln und Hamburg statt. Regionalität ist Trumpf!

Montag, 15. Juni 2009

Last und Lust der Kommiteesoftware

Gerade habe ich das Originalpaper "How Do Commitees Invent" von Mel Conway gelesen, dem Conway´s Law entstammt. Da ist mir unerwartet ein Schauer kalt den Rücken runtergelaufen bei dieser Aussage:

"To the extent that an organization is not completely flexible in its communication structure, that organization will stamp out an image of itself in every design it produces. The larger an organization is, the less flexibility it has and the more pronounced is the phenomenon."

image Nicht, dass ich Conway´s Law nicht schon vorher gekannt hätte. Aber manchmal vergrößert sich die Tragweite von Wissen durch neue Formulierungen oder einen anderen Blickwinkel einfach nochmal. Vielleicht liegt es auch daran, dass ich mich gerade Technologien abseits der Microsoft-Schiene oder überhaupt des Mainstreams annähere wie Erlang oder CouchDB. Jedenfalls habe ich den Absatz oben innerlich quasi simultan so gelesen:
"To the extent that Microsoft is not completely flexible in its communication structure, Microsoft will stamp out an image of itself in every design it produces. The larger Microsoft is, the less flexibility it has and the more pronounced is the phenomenon."

Und dann habe ich an den Entity Framework, an Oslo, an Visual Studio, an Windows und an andere Microsoft Produkte/Technologien gedacht. Microsoft hat sich seit 1990 und Visual Basic 1.0 sehr verändert. Für mich, der ich vor einigen Jahren noch viel mit Microsoft Deutschland zu tun hatte, war insbesondere ein Änderungsschub um 2002/3 zu spüren.

Wasfüreine Organisation ist Microsoft also heute? Inwiefern ist Microsoft "not completely flexible in its communication structure"? Das hat natürlich nur wenig damit zu tun, ob Microsoft-Mitarbeiter Email oder Blogs benutzen. Es geht vielmehr um die organisationsinternen Kommunikationswege und Weisungsbefugnisse.

Dieselbe Frage lässt sich natürlich auch Oracle oder IBM oder SAP stellen. Aber dort kenne ich mich nicht so mit den Produkten aus.

Sind Microsoft-Produkte heute also vielleicht schon quasi notwendig mehr Last als Lust? Sind sie womöglich heute schon weniger der Lösung eines Problems als der inneren Struktur von Microsoft angemessen? Hat Microsoft eine Größe und damit Kommunikationsstrukturen erreicht, die sozusagen notwendig zu Overengineering führen?

image Ich tendiere da mal zu einem vorsichtigen "Hm... es scheint immer mehr der Fall zu sein..." Das bedeutet nicht, dass nun alle Technologien über diesen Kamm geschoren werden müssten. Es geht nur um die Tendenz sowie eine daraus abzuleitende Vorsicht. Auch ist Microsoft inzwischen so groß, dass es immer wieder "Taschen der Widerstandes" geben kann und gibt, die nicht in die allgemeinen Kommunikationsstrukturen 100% eingebunden sind und insofern auch andere Systeme bauen können. Die Gruppe um die Concurrency Coordination Runtime fällt mir da ein oder das F# Team.

Doch sobald diese Taschen sich öffnen wollen, kollidieren sie natürlich irgendwann mit der "großen Organisation". Und dann kommt es darauf an... Was macht die mit diesen aus ihrer Sicht eigentlich anarchischen Systemen?

Technisch gesehen, läuft Microsoft qua seiner Größe und Organisation also langsam (oder immer schneller?) in den Morast. Die interessanten Sachen passieren dann irgendwann einfach dort nicht mehr. (Ja, ich weiß, wieviel Forschungsgelder Microsoft ausgibt. Dennoch ist es schwierig für eine solch große Organisation, den Geist der Anfangsjahre zu bewahren. Das ist lange, sehr lange recht gut gegangen - aber die Controller und damit die formale Kommunikation sind in unserer Wirtschaft ein Naturgesetz. Sie lassen sich hinauszögern, aber nicht vermeiden.)

Beweis #1: Das Internet. Microsoft hat es verschlafen und nur mühsam aufholen können. Beweis #2: O/R Mapping. Hier hat Microsoft lange geschlafen bzw. nichts zustande gebracht und ringt immer noch um ein vernünftiges Produkt. Beweis #3: IDE. Visual Studio kann einiges, aber die Qualität in puncto Flexibilität, wie sie heute so wichtig ist, die Eclipse bietet, hat VS nicht. Beweis #4: Microsoft Office. Ohne Zweifel hat Microsoft hier einen Standard geschaffen. Aber Innovation ist etwas anderes. Die spannenden Sachen wie realtime Kollaboration und neue Kommunikationsformen passieren z.B. bei Google.

Was den Technikern eine Last ist, mag anderen aber natürlich eine Lust sein. Controller lieben solche Moloche wie Microsoft. Hatte Microsoft lange Jahre mit dem Image einer "Bastelbude" zu kämpfen, die nicht "enterprise ready" ist, so gibt es diesen Zweifel in seiner grundlegenden Ausprägung nicht mehr. Microsoft ist hoffähig. Wer sich für Microsoft entscheidet - von BizTalk Server bis Entity Framework -, der wird nicht gefeuert, wenn es nicht klappt. Ob die Entscheidung allerdings in technischer Hinsicht die beste ist, hat damit nichts zu tun. Microsofts schiere Größe ist der scheinbare Garant für einen Mindesterfolg.

Nach Conway´s Law also mal meine These wie hier illustriert:

image

Eine gewisse Zeit lang nimmt die Qualität der Technologien durch Wachstum zu. Aber ab einer gewissen Größe sinkt sie eben - sogar unter das Ausgangsniveau. Mit "Qualität"  meine ich natürlich sozusagen die "overall user experience" von der Funktionalität über die Dokumentation bis zum Service.

Wünschen tue ich mir das für Microsoft oder IBM oder Google oder sonst einen Technologieanbieter nicht. Meine Befürchtung ist nur, dass es eben unvermeidlich ist. Deshalb sollten wir auf der Hut sein und gerade als Techniker immer unser Radar kreisen lassen auf der Suche nach Innovationen, die uns wirklich voran bringen. Das Entity Framework - sorry to say - gehört nicht dazu. Und ob Oslo "es reißen wird", halte ich auch noch nicht für ausgemacht.

Also: Wachsam bleiben! Links und rechts andere Technologien und Paradigmen anschauen. Nicht auf Microsoft warten. Im eigenen Haus nicht den Controllern die Technologieentscheidungen überlassen. Nur so erhalten wir uns die Lust an den Technologien, statt fatalistisch "Kommiteesoftware" hinterherzulaufen.

Freitag, 12. Juni 2009

Anforderungsaikido - Den Kunden mit gnadenlosen Requirements zur Agilität motivieren

Auf dem Architecture.NET Open Space neulich in Düsseldorf bin ich in einem Gespräch über einen interessanten Gedanken gestolpert. Thema war das Übliche:

Gemeinhin ist es ja so, dass der Kunde eine Anforderung stellt, das Team versucht sie umzusetzen und der Kunde dann irgendwie nicht ganz zufrieden ist.

Das ist für uns quasi normal, wenn auch unbefriedigend. Wir glauben nicht mehr daran, dass der Kunde genau weiß oder sagen kann, was er will. Also leben wir mit Experimenten, Angeboten, Glaskugelguckerei - und damit YAGNI.

Für den Kunden ist das aber keinesfalls normal. Der glaubt ja allermeistens, dass er genau weiß, was er will. Und er glaubt, dass er nach all den Sitzungen über Anforderungsdokumenten es auch richtig rübergebracht hat. So ist es kein Wunder, wenn er am Ende beim Test verwundert oder gar ärgerlich ist, nicht vorzufinden, was er gewollt hat.

Das mag objektiv ungerecht sein - subjektiv ist es aber so. Laien haben meist entweder den Eindruck, alles ausreichend spezifiziert zu haben, oder den Anspruch, dass die Softwareentwicklung in ihrer Weisheit die Lücken schon selbstständig schließen wird.

Wir wir alle wissen, ist das nicht so und funktioniert auch nicht.

Jetzt der interessante Gedanke: Damit wir nicht länger während der Implementierung rätseln, YAGNI vermeiden und der Kunde glücklicher wird, könnten wir es ja zur Abwechslung mal mit "gnadenlosen Requirements" versuchen. Gnadenlos nenne ich sie, weil es darum geht, immer genauer und genauer und genauer nachzufragen. Quasi bis in die Absurdität hinein.

"Lieber Kunde, willst du es so oder anders? Wenn so, willst du es dann genau so oder lieber so? Wirklich? Echt? Garantiert? Überleg nochmal. Oder möchttest du es doch vielleicht lieber leicht abgewandelt so?"

Das klingt nicht nur hier nervig in seiner Allgemeinheit. Auch in einem Kundengespräch ist das nervig. Dabei geht es allerdings nicht darum, wirklich das absolut letztendgültig "Richtige" aus dem Kunden herauszuholen. Nein, nein! Im Gegenteil! Auch wenn die konkreten Fragen sich natürlich auf seine Problemdomäne bzw. die vorgestellte Lösung beziehen, soll der Kunde nicht wirklich auf die immer detaillierter werdenden Frage eine präzise Antwort haben.

Der Kunde soll vielmehr selbst spüren, dass er keine (!) Antwort hat. Ja, ganz genau: Er soll an den Rand seiner Selbstsicherheit geführt werden. Es soll ihm durch immer weitergehende Entscheidungen, die tatsächlich nur er treffen könnte - aber eben nicht kann, weil er auch die Antwort nicht weiß -, gezeigt werden, dass er selbst (noch) nicht genau weiß, was er haben will.

Das Ziel der Anforderungsanalyse ist mithin nicht mehr, die Anforderungen genau zu erheben, sondern nur genügend gute Anforderungen zu bekommen, um loslegen zu können. Und darüber hinaus soll Kunde wie Team klar sein, dass eben viel im Unklaren ist und auch nicht klarer sein kann. Es geht halt nicht anders.

Damit ist dann der Kunde idealerweise weichgekocht für ein iteratives Vorgehen. Er kann dann auch gefühlsmäßig nachvollziehen, dass ihm nicht mit einer "Big Bang Lösung" gedient ist. Er ist dann selbst froh, sich seinen eigenen Vorstellungen schrittweise, iterativ anzunähern.

Gnadenlos ist solche Anforderungserhebung, weil sie den Kunden echt beim Wort nimmt. Er hat ja erstens den Anspruch, seine Anforderungen zu kennen, und zweitens den Glauben, dass die sich dann auch geradlinig und klar planbar umsetzen lassen.

Nun, dann nehmen wir ihn eben mit gnadenlosen Requirements ernst. Dann soll er mal die "Hosen runterlassen" und wirklich, wirklich detailliert jeden Fliegenschiss bestimmen. Er wird dann schon merken, dass er damit nicht weit kommt. Wichtig ist dafür natürlich, quasi nie mit den vom Kunden formulierten Anforderungen zufrieden zu sein. Er muss aufgeben beim Spezifizieren. Er muss sagen: "Ok, ihr habt gewonnen. Ich weiß es wirklich nicht genau. Versucht es also mal und zeigt mir das Ergebnis möglichst schnell. Aber dann lasst uns auch in kleinen Schritten vorgehen."

Akzeptiert sind gnadenlose Requirements erst, wenn der Kunde auf der Matte liegt und abklopft. Dann (!) können wir mit ihm ernsthaft sprechen. Dann machen heben wir ihn auf und versichern ihm, dass das alles gar nicht so schlimm ist. Es gibt einen Ausweg und der heißt agiles Vorgehen.

Ja, den Gedanken fand ich schon interessant. Mit gnadenlosen Requirements den Kunden mit den eigenen Waffen "agilitätsreif zu schießen" ;-) Oder etwas weniger brutal ausgedrückt: Anforderungsaikido. Die Energie des Kunden aufnehmen, weiterführen und ihn damit aus seiner Balancezone zu ziehen. Dann fällt er in unseren agilen Arme ;-) Ja, das klingt etwas netter, glaub ich.

Mittwoch, 10. Juni 2009

Einsteigen, bitte - Level 1 der School of .NET

Stefan Lieser hat nun schon eine erste Skizze zu einem Curriculum für unsere School of .NET geliefert. Damit stimme ich überein:

Es geht um die Grundlagen der Objektorientierung (in C# oder auch VB): Erst wenn diese Grundlagen jenseits von "OOP hat mit Klassen zu tun" klar sind, ist zu erwarten, dass neuere Konzepte wie dynamische Programmiersprachen, funktionale Programmierung, Workflows, Aspektorientierung  in ihrer Andersartigkeit allen Vor/Nachteilen gewürdigt werden können.

Der einzelne Entwickler ist im Fokus, um auch in einer Umgebung, wo nicht alle Entwickler auf demselben Stand sind, schnellstmöglich Fortschritte am Arbeitsplatz erzielt werden können. Persönliche Grundfitness steht am Anfang, bevor es an echte Teamarbeit geht. Die CCD-Bausteine der ersten Graden - allen voran konsequentes automatisiertes Testen - geben hier den Takt an. Ziel ist - so könnte man sagen - eine Konditionierung im Hinblick auf Testautomatisierung: in der School of .NET wird es von der ersten Übung an keinen Code geben, der nicht mit einem Testrahmen ausgestattet ist.

Im Sinne eines Menschenbildes, das von schrittweiser Entwicklung des Bewusstseins zu immer höheren Ebenen ausgeht - nicht nur im Allgemeinen, sondern auch in Bezug auf Fachkompetenzen - steht am Anfang die Auseinandersetzung mit Code auf den kleinsten physischen Abstraktionsebenen: Methode, Klasse, Assembly und ansatzweise Komponente. Synchrone, 1- oder 2-Tier Software muss gemeistert werden, um fit zu sein für die nächste Stufe.

Hinzufügen möchte ich für Level 1 der School of .NET allerdings noch...

  • Grundlagen des .NET Framework wie z.B. Streams, Exceptions, Instrumetierung, Linq, Extension Methods, Iteratoren, UserControls und mehr,
  • Grundlagend des O/R Mappings, weil Datenbankzugriffe immer noch für viele Projekte ein Thema sind, das unnötig viel Aufwand macht

Damit haben wir, glaube ich, ein ordentliches Curriculum beieinander. Mancher mag sich dabei allerdings fragen, warum das eine oder andere Thema nicht darin auftaucht. Was ist mit WinForms oder ASP.NET MVC oder Silverlight? Was ist mit Security? Warum kein ADO.NET?

Die School of .NET hat nicht zum Ziel, Technologietraining zu sein. Über die technologischen Feinheiten von WinForms oder Security oder ADO.NET wird allerorten berichtet. Dazu kann man sich auch ein Spezialtraining suchen oder die Literatur studieren.

Mit dem Curriculum der School of .NET möchten wir uns vielmehr auf das konzentrieren, was zum einen bisher weniger Raum einnimmt in der Ausbildung oder was sich schlecht in Büchern vermitteln lässt. Das sind Grundlagen, Zusammenhänge, Konzepte und Prozesse. Beispiele:

  • Bei Streams und Exceptions geht es uns nicht so sehr um die APIs des .NET Framework, sondern um die Konzepte. Ein streambasierter Umgang mit Daten ist etwas anderes als ein blockorientierter oder ein objektorientierter. Exceptions sind leicht zu werden und zu fangen; darüber müssen wir auch nicht reden. Aber wo einsetzen, welche Alternativen gibt es für die Meldung von (unvorhergesehenen) Zuständen: das ist konzeptionell interessant, das hat Auswirkungen auf den Anwendungsentwurf.
  • WinForms und GDI+ Feinheiten sind nicht ohne. Aber darüber lässt sich allerorten lesen, das kann man leicht selbst ausprobieren. Der konzeptionelle Umgang mit UserControls jedoch, ihr Platz im Entwurf, das ist etwas anderes. Hier gibt es Nachholbedarf.
  • Auch O/R Mapping ist für uns kein Technologie- sondern ein Konzeptthema. Die School of .NET wird kein Produkttraining durchführen. O/R Mapping soll vielmehr im Sinne von Patterns zu Bewusstsein gebracht werden.

Wer also spezielle Technologien trainieren will, der soll in ein Technologietraining gehen. Wer Hype hören will, der soll eine "Das ist alles neu in VS 20xx und .NET y.z"-Veranstaltung besuchen. Die School of .NET widmet sich - soweit es bei ihrem Plattformfokus geht - "Überzeitlichem". Mit dem Curriculum wenden wir uns an die, die einen Einstieg in die Plattform ernst meinen bzw. endlich ihre im Tagesgeschäft gewonnenen Erfahrungen auf soliden Untergrund stellen wollen.

Ein- und Umsteiger sind die primäre Zielgruppe für Level 1 der School of .NET. Für die Übergangsphasen zwischen Projekten und bei Aufnahme einer Tätigkeit ist das Level 1 gedacht. Berufsbegleitung bedeutet Entlastung des Betriebes bei der Ausbildung und Ergänzung anderer Ausbildungen im Sinne einer plattformspezifischen Konkretisierung und Vertiefung.

Und was kommt danach? Nach Level 1 kommt Level 2. Klar :-) Da geht es dann um:

  • Fortgeschrittene Objektorientierung z.B. mit AOP und dynamischen Sprachen
  • Echte Komponentenorientierung und Softwarearchitektur
  • Asynchrone Programmierung - lokal und verteilt, also N-Tier Szenarien
  • Die höheren Grade des CCD-Wertesystems mit Bausteinen wie automatisierter Produktion, iterativem Vorgehen oder statischer Codeanalyse

Level 2 richtet sich an den Entwickler im Team. Denn nur Teams können Software entwickeln, die intern auch als Team organisiert ist. Organisation und Produkt können nur co-evoluieren. Die Gestaltung von Level 2 ist insofern eine Konsequenz aus Conway´s Law. Asynchronizität und gar Verteilung können wir nur in den Blick nehmen, wenn wir uns auch organisatorisch mit autonomen Entitäten, den Entwicklern im Team auseinandersetzen. Aber dazu später mal mehr...

Jetzt werden wir erstmal School of .NET Level 1 in ein Angebot gießen. Soll die Innovation mal mit einem ersten Schritt beginnen...