Follow my new blog

Posts mit dem Label Intuitives Datenmodell werden angezeigt. Alle Posts anzeigen

Montag, 1. Juli 2013

Eine Black Box für Software

CQRS hat mich jetzt gepackt. Auf der DWX Konferenz hatte ich Gelegenheit, mich darüber länger mit Jan Fellien auszutauschen. Den Moment, wo ich innerlich “Aha!” und “Wow!” ausrief war, als ich erkannte, was die Aufgabe einer Event Source ist.

Nicht nur ist Event Sourcing für mich die Antwort auf meine Frage nach einem Datengranulat. Denn aus den “Daten-Kügelchen” vieler kleiner Events kann man sich größere Strukturen in immer neuer Weise “gießen”. Es gibt für mich nicht mehr die Frage, ob “das eine Datenschema” für eine Anwendung relational oder dokumentenorientiert oder sonstwie sein sollte. Stattdessen gibt es soviele Schemata und Datenbanken wie man braucht. Und alle werden aus der einen Quelle gespeist: aus der Event Source.

Daten für einen Zweck in einem bestimmten Schema bereitzustellen, kann immer dynamisch aus der Event Source geschehen. On demand. In dem Augenblick, wenn sie benötigt werden. Wem das zu langsam ist, der muss halt die Daten in dem Schema cachen. Doch das ist dann eine bewusste Optimierung.

Mit einer Event Source kann man diese Optimierung dann vornehmen, wenn man sie braucht. Bis dahin ist man frei von lästigen Überlegungen, wie denn ein Schema am besten aussehen sollte. Welche Erleichterung!

Aber dieser Gedanke hatte mich nicht überfallen auf der DWX. Den hatte ich schon vorher. Im Gespräch mit Jan kam mir vielmehr ein sehr mächtiges Bild für die Event Source in den Sinn.

Die Event Source ist die Black Box einer Software.

Ich meine das im Sinne der Flugschreiber, die auch als Black Box bezeichnet werden. Die zeichnen Ereignisse während des Fluges auf. Wenn etwas schief geht, kann man durch Abspielen der Aufzeichnung versuchen, die Ursache zu finden.

Das leistet für mich nun auch eine Event Source bzw. ein Event Store für Software. Alle Domänenevents werden doch gespeichert (record). So kann man den Zustand eines Programms zu jeder Zeit rekonstruieren. Was an Zustand in-memory ist nur eine Optimierung; Zustand in einem Read-Model ist auch nur eine Optimierung. Maßgeblich ist einzig das, was in der Black Box steht.

image

Wenn also ein Programm oder auch nur ein Teil abstürzt, kann es neu gestartet und aus der Event Source auf den letzten Stand gebracht werden (replay). Die Speicherung auch kleinster Veränderungen des Zustands ist ja kein Problem, weil die Events als “Zustandsdifferenzen” ganz simpel und schnell persistiert werden können.

Events kommen aus der Domäne. Da spielt die Anwendungsmusik. Dafür wird Software gemacht.

Die Domäne spielt immer wieder aber auch Events ab, da sie ja nicht ihren kompletten Zustand in-memory halten will.

Andere Konsumenten von Events werden über sie per Notifikation informiert. Die sind also von der Eventquelle entkoppelt. Falls sie jedoch offline waren, können sie sich “verpasste” Events wieder vorspielen lassen, um sich auf den aktuellen Stand zu bringen.

Bei CQRS ist ein typischer Event-Konsument natürlich das Read Model. Es fertigt aus einzelnen Events fixe größere Strukturen, die auf unterschiedliche Abfragemuster zugeschnitten sind.

Ich finde das Bild der Event Source als Black Box sehr eingängig und motivierend. Damit werde ich mich jetzt mal intensiver beschäftigen…

Montag, 31. Dezember 2007

OOP 2008: Assimilieren statt Speichern - Networking für Daten in einer dynamischen Welt

Alles soll heute flexibel sein: Menschen, die sich auf Jobangebote bewerben, genauso wie Programmiersprachen. Statisch ist out, dynamisch ist in. Nur noch nicht so recht bei den Daten. Denn da regieren Strenge und Statik. Daten werden einmal in Klassen oder Tabellen verpackt - und dann ändert sich diese Anordnung am besten nicht mehr. Falls doch, muss solche Veränderung gut geplant sein, damit die fein ziselierten Datenstrukturen nicht inkonsistent werden.

Datenspeicherung gehört zu einer statischen Welt

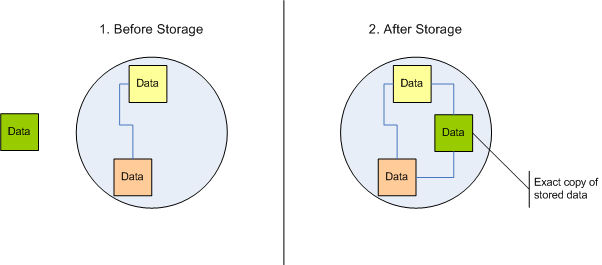
Daten in Container zu verpacken, die einander referenzieren, ist eben ein Informationsmodell für statische Datenstrukturen. Die Daten mögen sich ändern, aber die Strukturen, die Zusammenhängen bleiben konstant. Das ist völlig ok. Allerdings dient das vor allem einem Zweck: der 1:1 Speicherung und Reproduktion von Daten. Das Mittel der Wahl ist dabei das Kopieren dieser Daten. Wenn Sie z.B. Personendaten bestehend aus Vorname+Nachname in einer Datenbank speichern, dann werden die Bytes von Vorname und Nachname mindestens einmal in der Datenbank unverändert abgelegt, wahrscheinlich jedoch mehrfach. Jeder Index multipliziert ja gespeicherte Daten.

image

Dass die Geschichte der Softwareentwicklung sich bisher vor allem mit solcher Datenspeicherung beschäftigt hat, ist verständlich. Wenn man etwas mit Daten der äußeren Welt tun will, dann holt man sie am besten erstmal 1:1 "ins System". Mit einer Sprache wie SQL kann man sie dann bei Bedarf in Form von Views umarrangieren; allerdings funktioniert das nur in Maßen, denn SQL kann die grundsätzliche Container-Referenz-Dichotomie nicht aufheben.

Assimilierung für eine dynamische Welt

Seit der Geburt der relationalen Datenbanken sind nun aber einige Jahrzehnte vergangen. Die Welt hat sich verändert. Die Welt und damit die Anforderungen an die Datenbanken sind dynamischer geworden. Zusammenhänge, die gestern galten, sind morgen veraltet. Die auf Statik angelegten Datenstrukturen in heutigen Datenbanken sind somit kontraproduktiv. Sie sind wie Sand im Getriebe, wie Kalk in Gelenken.

Das Problem sind zum Einen die festen Containergrenzen, in die Daten in großen Blöcken eingepfercht sind. Denn Daten in Containern lassen sich nicht mit Daten in anderen Container in neue Beziehungen bringen. Nur Container selbst können einander referenzieren. Zum anderen sind Referenzen als Teil der Daten in Containern ein Problem. Solange Referenzen in Container stecken, müssen Containerstrukturen nämlich verändert werden, um neue Beziehungen herzustellen. Solche Schemaänderungen widerstreben dann zurecht jedem Datenbankadmin, denn sie widersprechen dem grundlegenden Paradigma der statischen Strukturen aller Container-Referenz-Datenmodelle.

Um nun Daten fit für eine dynamische Welt zu machen, muss also das Datenspeicherparadigma aufgegeben werden. In einer dynamischen Welt ist nicht mehr die 1:1 Speicherung und Reproduktion von Daten der Hauptzweck von Datenbanken. Die Reproduktion von Datenstrukturen ist nicht mehr der Rede wert; sie ist selbstverständlich.

Der Hauptzweck der Datenverarbeitung ist heute vielmehr die Flexibilisierung von Daten. Sie müssen so gehalten werden, dass jederzeit neue Zusammenhänge zwischen ihnen hergestellt werden können. Daten müssen fähig werden zum Networking. Business Intelligence (BI) ist zwar schon eine Disziplin, die sich der Schöpfung von Werten aus neuen Zusammenhängen zwischen Daten widmet. Aber auch BI ist letztlich noch dem bisherigen Datenspeicherungsparadigma verhaftet.

Wahre Dynamik und maximale Flexibilität erreicht die Datenverarbeitung erst, wenn Daten nicht mehr gespeichert, sondern assimiliert werden. Denn Daten wie andere "Dinge" der realen Welt, sind immer nur so flexibel, d.h. "verformbar", wie sie aus "verschiebbaren" Einzelteilen bestehen.

image

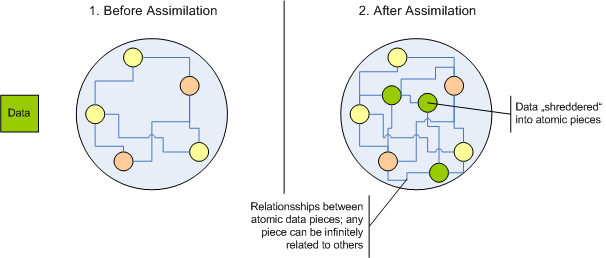
Dynamik kommt also erst in die Datenhaltung, wenn wir Daten nicht mehr als zu festen Blöcken in erhaltenswerten Containern zusammengesetzt ansehen, sondern als "Säcke" voller "Datenatome". Was diese Datenatome dann sind, ist zunächst einmal egal. Es können einzelne Bits, einzelne Zahlen, einzelne Zeichenketten oder einzelne 2 MB Blobs sein. Je feiner die Granularität dieser "Atome", desto höher jedoch die Flexibilität des "Datensacks".

Und nicht nur das! Denn diese "Datenatome" können nicht nur innerhalb eines Sacks immer wieder neu arrangiert, sondern können maximal flexibel mit "Datenatomen" anderer Säcke in Beziehung gesetzt werden. Statt Datenblöcke also einfach nur 1:1 zu speichern, müssen wir sie "shreddern". Dann erhalten wir maximal verbindbare "Datenatome". Und diese "Datenatome" assimilieren wir in eine "Wolke" schon existierender "Datenatome".

image

Assimilation besteht damit aus zwei Schritten:

  1. Datenblöcke in "Datenatome" zerlegen
  2. "Datenatome" mit schon vorhandenen vernetzen

Und der zweite Schritt kann sogar beliebig oft wiederholt werden! Per definitionem ist nicht zu befürchten, die Struktur der "Datenatome" je verändern zu müssen. Es sind ja Atome; aus Sicht einer Anwendung haben sie daher keine weitere, für zukünftige Beziehungen relevanten internen Strukturen.

Wo vorher noch Daten in Containern waren, sind nach der Assimilation die Container verschwunden und die Daten in eine "Datenwolke" (oder ist es eher ein "Datenplasma"?) aufgelöst und mit schon existierenden "Datenwolken" verschmolzen. Assimilation speichert Daten also nicht einfach, sondern löst sie in einem größeren Ganzen auf. Wie bei sonstigen Lösungen verschwindet das Aufgelöste jedoch nicht, sondern verteilt sich nur bzw. wird hier in das Vorherige integriert. Die ursprünglichen Daten sind also auch in der Gesamtheit alles Assimilierten noch enthalten - nur eben nicht klar umrissen an einem Ort wie die Datenkopien bei der üblichen Datenspeicherung. Dennoch lassen sich aus einem "Assimilat" auch wieder die ursprünglichen Daten in ihren Containern zum Zeitpunkt der Anlieferung regenieren.

Um Daten wahrhaft flexibel zu halten, müssen wir also das Operationenpaar Speichern/Laden durch das neue Paar Assimilieren/Regenerieren ersetzen. Dem bisherigen Grundanspruch der 1:1 Datenhaltung wird damit immer noch Rechnung getragen. Doch darüber hinaus eröffnet die assimilierende Datenhaltung ganz neue Möglichkeiten zur Vernetzung von Daten, zur Bildung immer neuer Zusammenhänge.

Assimilation ist die Grundlage für Synergieeffekte zwischen Daten. Durch Assimilation werden Daten so flexibel, wie sie eine immer dynamischer werdende Umwelt braucht.

Oder passend zum Jahresschluss: Speichern war 2007... Assimilation ist 2008.

Samstag, 24. Februar 2007

Das Intuitive Datenmodell III - Container als Dokumente

Im Intuitiven Datenmodell (IDM) sind alle Werte einzigartig. Es gibt nur einen Vornamen "Peter" und nur einen Preis 12,34, egal in wievielen Containern diese Daten vorkommen. Aber das gilt nicht nur für solche atomischen Daten, sondern auch für Zusammensetzungen!

Um das zu verdeutlichen, nehmen Sie eine relationale Datenbank mit einer Tabelle für Personen an:

Personen(Vorname, Nachname)

In der Tabelle stehen einige Datensätze:

Personen("Peter", "Mustermann")
Personen("Frank", "Müller")
Personen("Gabi", "Mustermann")
Personen("Gabi", "Müller")
Personen("Susanne", "Frank")

"Gabi" und "Frank" und "Mustermann" sind in der relationalen Datenbank selbstverständlich mehrfach enthalten, weil sie ja in mehreren Datensätzen vorkommen. Nicht so aber in einer intuitiven Datenbank (IDB)! Dort gibt es alle Zeichenketten nur einmal - unabhängig davon, wie sie in Containern gebraucht werden, d.h. ob sie einen Vornamen oder einen Nachnamen darstellen.

"Gabi" usw. sind im IDM atomische Werte (Atomic Value, AV). Für eine IDB sind sie quasi unteilbar, sozusagen kleine Blobs ohne weitere Struktur. Sie entsprechen den Spalten im Relationalen Datenmodell oder Feldern in Klassen des Objektorientierten Datenmodells.

Die Zusammensetzungen solcher AVs sind, wie könnte es anders sein, zusammengesetzte Werte (Composite Values, CV). Anders als im Relationalen Datenmodell sind CVs allerdings beliebig tief schachtelbar. Die Schachtelungstiefe in einer relationalen Datenbank ist flach: Tabelle/Satz/Spalte. Das war´s. Bei Klassen ist es etwas anders, da können Felder Strukturen (struct) enthalten, die wiederum Strukturen enthalten können usw. Objekte sind in anderen allerdings nicht physisch enthalten wie Datensätze in Tabellen. Wenn man davon spricht, dass ein Objekt ein anderes enthält, dann ist das nur eine logische Enthalten-Beziehung, die durch Referenzen hergestellt werden muss.

Das IDM steht mit seiner beliebig tiefen Schachtelung, die keiner Ebene irgendeinen Vorrang gibt, daher dem XML Datenmodell am nächsten. Deshalb möchte ich die "Dateneinheiten", die man einer IDB zur Speicherung übergibt oder aus ihr ausliest, auch Dokumente nennen. Damit soll natürlich keine Nähe zu Word- oder Excel-Dokumenten suggeriert werden. Dokumente sind einfach nur Zusammenfassungen von Werten in einer für einen bestimmten Zweck geeigneten Struktur. Ob diese Werte dann Kalkulationen oder eine Bibliographie oder Kontaktdaten darstellen, ist unerheblich. Alles kann zu einem Dokument zusammengefasst werden. Und alles kann auch in immer wieder neuen Dokumenten zu einander in Bezug gesetzt werden.

Die obigen Daten könnten einer IDB also z.B. in Form mehrerer Dokumente zur Speicherung übergeben werden. Das IDM basiert nicht auf XML, aber ich kann XML zur Beschreibung von IDB Dokumenten benutzen. Dann sähen die Dokumente für die obigen Daten z.B. so aus:

<Person>
<Vorname>Peter</Vorname>
<Nachname>Mustermann</Nachname>
</Person>


oder

<Person vorname="Peter" nachname="Mustermann"/>

Atomische Werte könnten als Subelemente oder als Attribute notiert werden.

Aber auch eine knappere Notation ist möglich, die eher der obigen für die Tabellen entspricht:

Person(Vorname("Peter"), Nachname("Mustermann"))

Sie steht XML ins nichts nach. Auch mit ihr kann ich Schachtelungen ausdrücken:

Personen(
Person(Vorname("Peter"), Nachname("Mustermann"))
Person(Vorname("Klaus"), Nachname("Müller"))
)

Welche Notation ich im Folgenden benutze, hängt wahrscheinlich von meiner Tagesform ab ;-) Beide sind einfach zu lesen, denke ich.

Eine Abbildung nach XML ist mir vor allem wichtig, um zu zeigen, dass das IDM nicht nur "outspacet" ist. Wer XML kann, der hat im Grunde von viel vom IDM verstanden.

Und eine Abbildung auf zwei Notationen ist mir wichtig, um klar zu machen, dass das IDM eben letztlich notationsunabhängig ist. Beim IDM geht es nicht wie bei XML ursprünglich nur um Text. Es geht um ein Werteuniversum - dessen Inhalt sich auch in eine textuelle Dokumentenwelt abbilden lässt. Denn wie die Dokumente bzw. Daten intern abgelegt sind, ist unerheblich für das Intuitive Datenmodell. Es muss nur verwirklicht sein. Insofern ist auch eine objektorientierte Schnittstelle denkbar, z.B.

IIntuitiveDatabase db;
...
ICompositeValue person = db.CreateCV("Person");
person.Subvalues.Add(db.CreateAV("Vorname", "Peter"));
person.Subvalues.Add(db.CreateAV("Nachname", "Mustermann"));
...
db.Store(person);

Aber das sind im Augenblick Details. Wichtig ist, dass IDBs Dokumente speichern und liefern. Allerdings werden diese Dokumente nicht 1:1 in einer IDB abgelegt. Eine IDB speichert ja keine Kopien von Daten. Vielmehr werden die Dokumente "geshreddert" und so mit den schon vorhandenen Dokumenten "verwoben", dass den Bedingungen des IDM Genüge getan ist. Statt speichern würde ich eher sagen, dass IDBs Dokumente assimilieren. Sie nehmen sie auf, machen sie sich zu eigen - aber die Dokumente selbst verschwinden in dem Vorgang. Sie sind in der IDB nicht mehr ohne Weiteres erkennbar. Selbstverständlich kann man sie aber dennoch wieder herausbekommen ;-) Das Speichern von Daten in einer IDB ist insofern verlustfrei.

Wenn ich sage, dass die Dokumente bei der Assimilierung verschwinden, dann möchte ich damit vor allem ausdrücken, dass eben keine einfachen Kopien von Daten in einer IDB abgelegt werden. Wenn ich Daten einer relationalen Datenbank hinzufüge (z.B. Personen mit jeweils mehreren Adressen), dann führt das quasi immer dazu, dass neue Datensätze erzeugt werden. Füge ich ein Dokument mit demselben Inhalt einer IDB hinzu, dann kann es aber sein, dass nichts passiert oder nur sehr wenig. Denn wenn ein neues Dokument Werte enthält, die schon assimiliert wurden, dann werden die eben nicht nochmals in der IDB angelegt.

Insofern würde ich auch nicht sagen, dass in einer IDB diese oder jene Dokumente stecken. Die Dokumente A, B und C mögen assimiliert worden sein. Sie sind also schon in der IDB irgendwie drin und können auch wieder herausgeholt werden. Viel wichtiger ist aber das große Ganze, das durch die Assimilation entstanden ist. Aus dem können nämlich nicht nur A, B und C wieder generiert werden, sondern auch noch viele andere, neue, unvorhergesehene Dokumente, die sich quasi "einfach so" ergeben, weil A, B und C Gemeinsamkeiten aufweisen.

Diese Gemeinsamkeiten müssen dabei nicht nur bei AVs liegen, sondern können auf jeder Ebene eines Dokuments, d.h. bei den CVs liegen. Das (!) ist der entscheidende Unterschied zu einer relationalen Datenbank oder einer XML-Datenbank.

Sonntag, 11. Februar 2007

Das Intuitive Datenmodell II - Es kann nur einen geben

Wie im ersten Artikel beschrieben, halte ich die grundsätzliche Container-Referenz-Dichotomie aller existierenden Datenmodelle für ein ebenso grundsätzliches Problem. Sie ist wie eine gläserne Decke: Wir können durch sie Problemlösungen in weiter ferne sehen - aber sie lässt sie uns nur schwer oder gar nicht erreichen.

Prinzipiell, ganz prinzipiell mag sich womöglich jedes Datenmodellierungsproblem mit jedem existierenden Datenmodell irgendwie realisieren lassen. Genauso ist es aber prinzipiell auch möglich, jede Software in Maschinencode zu schreiben.

Ob die heutigen Datenmodelle ausreichend für die Zukunft sind, lässt sich daher nicht anhand dessen entscheiden, ob sich prinzipiell alle Modellierungsprobleme mit ihnen bewältigen lassen. Ihre Eignung ist vielmehr immer wieder (auch) an der Leichtigkeit zu prüfen, mit der sich Lösungen auf ihrer Grundlage finden lassen. Und genau da sehe ich Grenzen.

Etwas greifbarer werden diese Grenzen vielleicht mit folgendem Bild:


Container können gewöhnlich ineinander geschachtelt werden, aber eine Beziehung lässt sich zwischen ihnen nur auf einer Ebene aufbauen. Objekte können nur andere Objekte referenzieren und nicht Teile von Objekten. Dasselbe gilt für Datensätze in relationalen Datenbanken. Nur bei XML ist es etwas anders: Dort kann jedes Element in beliebiger Schachtelungstiefe mit einer ID versehen werden, auf die woanders Bezug genommen werden kann.

Die außer bei XML stark beschränkte Schachtelungstiefe im Verein mit nur einer adressierbaren Ebene von Containern macht es schwierig, Daten zu modellieren. Welche Daten sollten echt ineinandergeschachtelt werden? Welche Daten sollten besser über Referenzen verbunden werden?

Diese Fragen stellen sich, solange überhaupt noch eine Entscheidung zwischen Container und Referenz getroffen werden muss. Was aber, wenn diese Entscheidung überflüssig würde? Was, wenn es nur noch ein Konzept gäbe? Das ist die Idee hinter dem Intuitiven Datenmodell (IDM) bzw. einer es implementierenden Intuitiven Datenbank (IDB, Intuivite Database).

Eine Datenwelt nur noch bestehend aus Containern
Im Intuitiven Datenmodell gibt nur noch Container. Das IDM kennt keine Referenzen mehr. Alle Daten bestehen aus einer beliebig tief geschachtelten Menge von Containern - oder besser: Daten werden als eine Hierarchie von Werten angesehen. Im IDM gibt es nur noch Werte.

Allerdings haben diese Werte eine ganz besondere Eigenschaft: sie sind immer einzigartig. In einer IDB existiert jeder Wert nur einmal! Das IDM beschreibt daher ein "universe of unique values". Sie können es von daher auch als mathematische Menge auffassen. Z.B. gibt es in der Menge der natürlichen Zahlen jede Zahl nur einmal.

Allerdings unterscheidet sich das IDM auch gravierend von einer mathematischen Menge. Denn in einer IDB ist nicht nur jedes "Element", jeder Wert einzigartig, sondern kann selbst wieder Werte enthalten, die dann ebenfalls zur IDB gehören. Ein Wert selbst ist allerdings keine Menge, d.h. er kann den selben Wert mehrfach enthalten. Dennoch ist dieser eingeschachtelte Wert in einer IDB nur einmal vorhanden.

Das IDM kennt zunächst zwei Arten von Werten: atomische Werte (Atomic Values, AV) und zusammengesetzte Werte (Composite Values, CV).


Einn AV ist unteilbar und enthält keine weiteren Werte.

Ein CV hingegen besteht aus anderen Werte, die zusammen seinen Wert ausmachen. Der Wert eines CV ist quasi die "Summe" der in ihm enthaltenen Werte (Subwerte).

Da eine IDB jeden Wert nur einmal enthalten kann, lassen sich Werte auch als Identitäten auffassen. Die Identität eines CV ist dann zusammengesetzt, so wie die Identität einer Gruppe von Menschen auch zusammengesetzt ist aus den Identitäten der einzelnen Personen.

Während der Wert eine AV jedoch noch quasi gleichgesetzt werden knn mit den rohen Daten, die er enthält (z.B. ein Name oder eine Telefonnummer oder ein Preis), so ist der Wert eines CV schnell nur noch abstrakt zu fassen; es wäre unhandlich, ihn als Verknüpfung seiner Subwerte zu notieren.


CVs sind genauso einzigartig wie das, für was sie in der realen Welt stehen. Und das ist ein erstes Indiz dafür, warum ich das Datenmodell als intuitiv bezeichne.

In der realen Welt gibt es nur Einzigartiges. Jeder Mensch, jedes Blatt am Baum ist einzigartig, jedes Auto, jeder Bleistift ebenso. Und wenn zwei Dinge noch so gleich aussehen, so sind sie doch nicht dieselben. Selbst eine exakte Kopie, selbst ein geklontes Lebewesen hat eine eigene Identität. Alles Materielle gibt es also nur einmal.

Und genau diesen Umstand, mit dem wir alle täglich souverän umgehen, übertragt das IDM in die Welt der Datenmodellierung. Eine IDB enthält keine Kopien so wie relationale Datenbanken oder Objektmodelle. In einer IDB ist alles einzigartig.

Und das hat Folgen... die ich aber erst im nächsten Artikel beschreiben will.

Sonntag, 28. Januar 2007

Das Intuitive Datenmodell I

Ich möchte ein neues Datenmodell vorschlagen. Eines, das sich radikal von denen unterscheidet, die Sie täglich in der Softwareentwicklung einsetzen.

Ich möchte ein Datenmodell vorschlagen, dass nur noch Werte kennt und keine Referenzen mehr zwischen diesen Werte. Diese konzeptionelle Reduktion macht es ohne Verlust an breiter Einsetzbarkeit in vielen Fällen einfacher zu handhaben als andere Datenmodelle, eröffnet darüber hinaus aber auch ganz neue Perspektiven auf den Umgang mit Daten.

Motivation
Sie haben das Objektorientierte Datenmodell verinnerlicht, denken täglich in den Bahnen des Relationalen Datenmodells, jonglieren mit XML und haben bestimmt auch von anderen (persistenten) Datenmodellen [1,2] gehört wie dem Hierarchischen oder gar dem Assoziativen Datenmodell.

Diese Datenmodelle haben natürlich alle ihre Berechtigung. Jedes versucht auf seine Weise das Problem zu lösen, Datenzusammenhänge der realen Welt für Software bearbeitbar zu machen. Und das leisten sie grundsätzlich auch.

Sind die existierenden Datenmodelle deshalb aber perfekt? Könnte die Datenmodellierung nicht für manche oder gar viele Fälle einfacher oder flexibler sein? Ich glaube, ja. Ich glaube, wir sind schon so sehr gerade in die Mainstream-Datenmodelle eingetaucht, dass wir den Schmerz, den sie uns manchmal bereiten, nicht mehr spüren. Sie sind ja auch zumindest so leistungsfähig, dass wir am Ende irgendwie alle Datenmodellierungsprobleme lösen. War das dann allerdings so einfach, wie es hätte sein können?

Gewöhnlich beantworten Sie diese Frage von einem Standpunkt innerhalb der Menge der existierenden Datenmodelle. Sie überlegen, ob Sie ein Datenschema mit den vorhandenen Mitteln, den Konzepten des gewählten Datenmodells, auch wirklich gut entworfen haben – oder ob vielleicht ein anderes der verfügbaren Datenmodelle etwas geeigneter gewesen wäre.

Eine verständliche Haltung und die allermeiste Zeit können wir uns auch keine andere leisten. Wir müssen mit den Werkzeugen leben, die wir haben.

Wenn die Antworten dann aber immer wieder schwer fallen, wenn sie immer wieder lauten, „Ja, ich habe es so gut gemacht, wie es das Datenmodell erlaubt, aber irgendwie ist das Ergebnis trotzdem unbefriedigend“, dann kann es Zeit sein, den Standpunkt zu wechseln und über den Tellerrand zu schauen.

Solche Antworten sind es nun, die mich angetrieben haben, über die existierenden Datenmodelle hinaus zu denken. Trotz oder wegen aller Vertrautheit mit der Objektorientierung, RDBMS und XML bin ich immer wieder in Situationen geraten, wo ich diese Datenmodelle als umständlich oder beschränkend empfunden habe. Der Grund: sie leiden alle am selben Problem.

Die Container-Referenz-Dichotomy als Grundproblem
Die existierenden Datenmodelle [1,2] basieren alle auf einer grundlegenden Dichotomie, der zwischen Containern und Referenzen. Sie sind die wiederkehrenden, fundamentalen Konzepte aller Datenmodelle.

Egal, ob Sie objektorientiert oder relation modellieren, Sie müssen sich immer wieder dieselbe Frage stellen: Fasse ich diese und jene Daten zusammen in einen Container oder soll ich sie lieber auf verschiedene Container aufteilen und dann die Container einander referenzieren lassen?

Sind die Container Objekte oder Datensätze? Heißen die Referenzen Objektvariable oder Fremdschlüssel? Das sind Feinheiten. Ihre Frage ist trotzdem dieselbe. Und sie ist nicht leicht zu beantworten, denn eine Entscheidung hat weitreichende Folgen:

  • Ob Daten zusammen im selben Container liegen oder nur über Referenzen verbunden sind, hat Einfluss auf die Form des Codes zur Speicherung und zur Abfrage. Das hat wiederum Auswirkung auf die Performance.

  • Ob Daten heute zusammen mit anderen in einem Container liegen oder für sich allein, hat Auswirkungen darauf, wie Sie morgen Bezug auf sie nehmen können. Um Daten in neue Zusammenhänge stellen zu können, müssen sie auf den Punkt referenzierbar sein; das sind sie aber nur, wenn sie allein in einem Container stehen. Ihre Entscheidungen für Container und Referenzen haben also Auswirkungen auf die Flexibilität Ihres Datenmodells.

Zur immer wieder zu fällenden Entscheidung zwischen Container und Referenz tritt eine Beschränkung der Schachtelung von Containern. Sie können Daten in Felder/Spalten stecken, die dann zu Klassen/Tabellen zusammenfassen… und das war´s. Sollten Daten in der Realität jedoch in tieferen Hierarchien stecken, dann müssen Sie sie „flachklopfen“, um sie mit den existierenden Datenmodellen abzubilden. Nur XML macht hier eine Ausnahme, hat aber nicht den Stellenwert als Datenmodell, den Objektorientiertes oder Relationales haben.

Bei aller Liebe zu den Mainstream-Datenmodellen empfinde ich sie also zunehmend als beschränkend und umständlich. Sie sind leistungsfähig und etabliert… aber für bestimmte Anwendungsfälle scheinen sie mir inzwischen unzeitgemäß:

  • Für eine Softwarewelt, in dem immer mehr flexibel und dynamisch passieren soll – die dynamischen Sprachen wie Ruby oder Python sind dafür nur ein Beisiel –, sind ihre Schemata zu starr.
  • Für eine Softwarewelt, in der immer mehr ad hoc entwickelt werden soll, weil keine Zeit für lange Planung ist, sind ihre Schemata zu schwer zu entwerfen. Entscheidungen über Datennormalisierung können nur von Fachleuten getroffen werden; der Poweruser ist überfordert.
  • Für eine Softwarewelt, in der es immer mehr gilt, „Wissen“ aus schon Vorhandenem zu heben (Datamining), bieten existierende Datenmodelle zuwenig Hilfe bei der Vermeidung oder Auflösung von Dateninseln.
Soweit die Probleme mit heutigen Datenmodellen aus meiner Sicht. Verstehen Sie, warum ich mich motiviert gefühlt habe, nach einer Alternative bzw. Ergänzung zu suchen? Gefunden habe ich dann schließlich einen Ansatz, den ich das Intuitive Datenmodell nennen möchte.

Davon mehr im nächsten Artikel dieser Serie.

Ressourcen
[1] UnixSpace, Database Models, http://unixspace.com/context/databases.html
[2] Mike Prestwood, An Introduction to Object Orientation, http://www.prestwood.com/ASPSuite/KB/document_view.asp?qid=100137