Follow my new blog

Sonntag, 17. Februar 2008

Warum Veränderung es schwer hat in der Softwareentwicklung [OOP 2008]

Grad lese ich "The Art of Change" von Loebbert und muss innehalten, weil mir aufgeht, was oft schiefgeht. In den Gesprächen auf der VSone und anschließenden Architekturworkshop habe ich immer wieder Aussagen gehört wie: "Ich würde gerne anwenden, was Sie sagen, aber in unserem Unternehmen geht das nicht. Der Chef/der Projektleiter/... sagt immer, dass das früher ja auch nicht nötig war."

Auf die genaue Begründung, die dem Chef/Projektleiter usw. in den Mund gelegt wird, kommt es nicht an. Gemeinsam ist allen, dass den Führungspersonen keine Einsicht in die Notwendigkeit eine Veränderung in den Mund gelegt wird.

Angesichts meiner Lektüre habe ich mich nun gefragt, was es so schwierig macht, Veränderungen in der Softwareentwicklung anzuregen und durchzuführen. Meine heutige Erkenntnis: Es ist so schwierig, weil es Missverständnisse gibt und Wahrnehmungsorgane fehlen.

Ordnungen der Veränderung

Missverständnisse beim Gespräch über Veränderungen rühren von einer undifferenzierten Betrachtung her. Die an der Softwareentwicklung beteiligten glauben nämlich oft, dass Veränderungen nicht nötig seien, weil sie ja ohnehin schon die ganze Zeit in einer Projektsituation leben, die von Veränderungen nur so strotzt. Warum also noch mehr verändern, wenn die ständigen Veränderungen heute schon an den Rand des Machbaren gehen?

Undifferenziert ist diese Sichtweise, weil sie alle Veränderungen in einen Topf schmeißt. Neue Funktionalität, neue Technologien, neue Teamorganisation: das alles ist einerlei.

Um notwendige Veränderungen plausibler zu machen, scheint mir daher zunächst wichtig, genauer hinzuschauen. Ich teile Veränderungen daher mal in 5 Ordnungen ein:

0. Ordnung: Veränderungen im Sinne eines Kunden sind für mich Veränderungen 0. Ordnung. Ein neues Feature, eine Fehlerkorrektur, höhere Performance... wird Software modifiziert, um funktionale und nicht funktionale Anforderungen zu implementieren, sind das Veränderungen 0. Ordnung. An ihnen ist aber nicht nur der Kunde interessiert. Sie sind es auch, auf die Führungskräfte besonders ihren Blick richten.

1. Ordnung: Bei Veränderungen 1. Ordnung werden Materialien verändert. Holz wird zu einem Schrank verarbeitet, APIs und Daten zu einer Software. Wenn einer ein Werkzeug in die Hand nimmt (z.B. Visual Studio), damit Material bearbeitet (z.B. den WinForms API) und zu einem Produkt zusammenfügt, dann ist das eine Veränderung 0. Ordnung. Das, was zu tun ist, ist klar. Es muss nur einfach getan werden. Dabei verändern sich die Rohstoffe hin zum Produkt im Sinne der Kundenanforderungen. Das ist die tägliche Arbeit der Softwareentwickler. Veränderungen 1. Ordnung werden vorgenommen, um Veränderungen 0. Ordnung zu bewirken.

2. Ordnung: Veränderungen 1. Ordnung finden in einem Rahmen statt. Das ist die Grundstruktur oder auch Architektur einer Software. Wenn sich dieser Rahmen ändert, dann ist das eine Veränderung 2. Ordnung. Sie ändert nichts an der Rohstoffveränderung/-verarbeitung, nichts an den Features einer Software, sondern nur die strukturellen Zusammenhänge, in denen die Veränderungen 0. und 1. Ordnung stattfinden. Ziel von Veränderungen 2. Ordnung ist das technische Fundament, auf dem Software ruht.

3. Ordnung: Was hergestellt wird, ist eingebettet in einen Herstellungsprozess. Veränderungen an ihm sind Veränderungen 3. Ordnung. Hierzu zähle ich z.B. die Einführung von Unit Tests oder Continuous Integration oder den Umstieg von VSS auf TFS. Werden diese und andere Konzepte bzw. Werkzeuge eingeführt, die die Art ändern, in der Code produziert wird, dann geht es um Veränderungen 3. Ordnung.

4. Ordnung: Schließlich kann sich auch noch der Rahmen ändern, in dem der Herstellungsprozess abläuft. Wenn Teamorganisation und Vorgehensmodell verändert werden sollen, dann sind das Veränderungen 4. Ordnung. Früher ad hoc Tests, heute Unit Tests - das ist eine Veränderung 3. Ordnung. Aber früher ad hoc Programmierung, heute eXtreme Programming, das überhaupt den Ausschlag für Unit Tests gegeben hat - das ist eine Veränderung 4. Ordnung. Ändern sich die Rollen, ändern sich die Vorgehensschritte (z.B. durch Einführung einer QS oder eines Change Management oder von time boxes Releases), dann sind das Veränderungen 4. Ordnung.

5. Ordnung und höher: Veränderungen höherer Ordnung betreffen nicht mehr unmittelbar das Softwareentwicklungsteam, sondern seine Umwelt. Dazu gehören zum Beispiel Firmenzusammenschlüsse oder die Einführung von Teleworking.

Mit diesen Ordnungen von Veränderungen in der Hand, können Sie in Zukunft sehr einfach die Empfehlungen einordnen, die Sie lesen oder hören. Sie lesen einen Artikel über Scrum - und Sie wissen sofort, dass es um Veränderungen 4. Ordnung geht. Sie lesen einen Artikel, der den Einsatz von BizTalk Server empfiehlt - und Sie wissen, dass die Umsetzung der Empfehlung eine Veränderung 2. Ordnung bedeutete. Den üblichen Artikeln in Fachzeitschriften nach dem Motto "Mehr Performance durch xyz" oder "Best Practices für den Einsatz von abc" geht es um Veränderungen 1. Ordnung.

Ordnungsbeziehungen

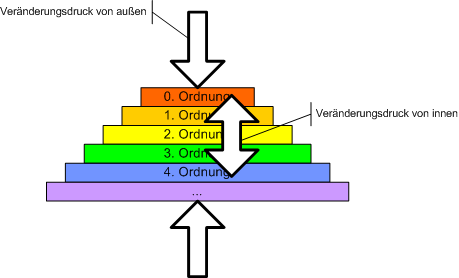
Die Ordnungen der Veränderung bilden eine Hierarchie, die ich einmal als Pyramide darstelle:

image

Höhere Ordnungen sind darin das Fundament für Veränderungen niederer Ordnung. Veränderungen der Ordnung n führen zu Strukturen, die Voraussetzung für Veränderungen der Ordnung n-1 sind. Oder anders ausgedrückt: Veränderungen der Ordnung n-1 sind eingebettet bzw. basieren auf vorherigen Veränderungen der Ordnung n:

  • Veränderungen an funktionalen und nicht funktionalen Features einer Software setzen Veränderungen an den "Softwarerohstoffen" voraus.
  • Veränderungen an und mit "Softwarerohstoffen" sind immer eingebettet in einen Architekturrahmen und insofern auch abhängig von Veränderungen an ihm.
  • Veränderungen am Architekturrahmen setzen voraus, dass sie auch getestet, produziert und deployt werden können. Sie basieren also auf einem angemessen veränderten Produktionsprozess.
  • Veränderungen am Produktionsprozess sind nur möglich, wenn sich auch das Vorgehensmodell um ihn, also die Teamorganisation verändert.

Um Veränderungen n-ter Ordnung durchzuführen, sind also ggf. vorher Veränderungen (n+1)-ter Ordnung vorzunehmen.

Den Ordnungen der Veränderungen entsprechen natürlich Ebenen von Systemen (bestehend aus Strukturelementen und Beziehungen) und Prozessen. Diese Systeme und Prozesse sind es, die verändert werden. Insofern beschreibt die obige Pyramide auch eine Hierarchie von Systemen/Prozessen, die aufeinander aufsetzen:

  • Das System der kundenrelevanten Features basiert auf einem System von Codeeinheiten.
  • Das System der Codeeinheiten basiert auf bzw. manifestiert ein Modellsystem, die Architektur.
  • Die Architektur ist eingebettet in ein Produktionssystem und QS-Prozesse.
  • Produktion und QS sind Ergebnis der Zusammenarbeit innerhalb des sozialen Systems Projektteam.

Keine Veränderung ohne Druck

Veränderungen sind kein Selbstzweck. Niemand verändert sich - allemal kein Unternehmen -, ohne einen Druck wahrzunehmen, der eine Veränderung zumindest nahelegt, um in Zukunft weniger Druck zu verspüren.

Woher kommt der Druck, um Veränderungen verschiedener Ordnung anzustoßen? Vor allem kommt Druck natürlich von außen. Der Kunde äußert Anforderungen, die in Veränderungen 0. Ordnung resultieren, die auf Veränderungen 1. Ordnung basieren. Ebenso sind es vor allem die expliziten Kundenanforderungen, die Veränderungen der 2. Ordnung anstoßen. Aber auch neue Optionen der Technologieanbieter können sie ermuntern.

Doch schon für Veränderungen 2. Ordnung sind die Impule von außen vergleichsweise schwach. Ganz zu schweigen von Veränderungen höherer Ordnung. Kein Kunde wünscht sich eine bestimmte Produktionsweise oder ein konkretes Vorgehensmodell.

Bei gegebenen Systemen und Prozessen ab Ebene 2 stellt sich daher die Frage: Woher kommt Veränderungsdruck? Warum sollten Veränderungen 2., 3. oder 4. Ordnung überhaupt durchgeführt werden?

Und genau da liegt das Hauptproblem vieler Softwareprojekte, scheint mir. Ein mangelnder Druck von außen ist der Grund für die oben erwähnte Aussage von Entwicklern. Ein Blick auf die Pyramide zeigt auch: Für den Kunden - und somit für Führungskräfte - unmittelbar relevant ist nur die Ebene 0. Nur (oder vor allem) Veränderungen 0. Ordnung werden von ihnen wahrgenommen.

Wahrnehmungsorgane für Veränderungsdruck

Ich denke, es mangelt an Wahrnehmungsorganen für Veränderungsdruck. Das hauptsächlich ausgeprägte ist das Ohr für den Kunden. Wenn er sich räuspert, dann wird die Veränderungsmaschinerie angeworfen. Dann sind Veränderungen 0. Ordnung gefragt - egal wie.

Aber wo Veränderungsdruck von außen kommen kann, kann er natürlich auch von innen kommen. Veränderungen n-ter Ordnung können "von innen" Druck auf andere Ebene ausüben, d.h. Veränderungen (n-1)-ter oder (n+1)-ter Ordnung motivieren. Doch diese Form von Druck muss man natürlich wahrnehmen können.

Veränderungen erzeugen Unterschiede. Manche dieser Unterschiede können dann einfach so groß sein, dass sie einen Unterschied auf anderer Ebene nach sich ziehen sollten. Quantitative Unterschiede sind dafür gute Kandidaten. Ein Beispiel aus der Verkehrswelt: Solange es nur wenige Autos gab, regelte der Verkehr sich quasi von selbst. Nur durch eine größere Quantität der Autos war es dann jedoch ab einem bestimmten Punkt nötig, explizite Regelungen einzuführen. Verkehrspolizisten und Ampeln waren die Folge. Veränderungen n-ter Ordnung (Zahl der Autos) zogen also Veränderungen (n+m)-ter Ordnung (Regelungskonzept) nach sich.

Warum sollte Software davon ausgenommen sein? Wenn bei einer Softwaregröße g zu einem Zeitpunkt tg Systeme und Prozesse auf allen Ebenen passend waren, dann heißt das doch ganz selbstverständlich nicht, dass bei einer Softwaregröße h>g zum Zeitpunkt th>tg dieselben Systeme und Prozesse immer noch passend sind.

Dasselbe gilt für weniger konkrete Umwelteinflüsse als funktionale Kundenanforderungen. Zeitrahmen oder Budget sind Umwelteinflüsse, denen ein Softwaresystem auf allen Ebenen angepasst sein sollte. Ändern sich Zeitrahmn und Budget, so kann das eigentlich nur durch Veränderungen unterschiedlicher Ordnung kompensiert werden.

Vom Entwickler bis zum Chef sollten daher alle Beteiligten bei jeder Veränderung in der Umwelt fragen, Veränderungen welcher Ordnungen dadurch für das Projektteam bzw. Softwaresystem angezeigt sind. Wahrnehmungsorgane für Veränderungsdruck auszubilden ist also gar nicht so schwierig. Eigentlich genügt es zunächst, Unterschiede nicht nur in der Umwelt, sondern auch "im System" überhaupt ersteinmal wahrzunehmen. Auch und vor allem, wenn sie nicht antizipiert oder selbst verursacht sind.

Ist es schwieriger geworden, neue Features einzubauen? Nimmt die Menge an Code zu, von der nicht mehr ganz klar ist, wozu sie dient? Steigt der Aufwand, um Performancelecks zu finden? Meldet der Support Fehler, die eigentlich schon länger behoben sein sollten?

Das sind Fragen, die, wenn mit Ja beantwortet, Unterschiede aufzeigen, die Veränderungsdruck darstellen, auch wenn er nicht unmittelbar von einem Kunden ausgeht.
image

Kunden (und ihre Stellvertreter wie Verkauf oder Chef) üben Veränderungsdruck auf Software aus. Aber je älter und größer eine Software wird, desto mehr Druck übt sie auf sich selbst aus. Das ist dann Druck von innen.

Solcher Druck ausgehend von Ebene n kann dann nahelegen, Veränderungen (n+1)-ter oder (n-1)-ter Ordnung durchzuführen. Manchmal ist seine Reichweite aber auch größer. Ändert sich das Vorgehensmodell (4. Ordnung), hat das wahrscheinlich Auswirkungen auf die Produktion (3. Ordnung) oder gar auf die Architektur (2. Ordnung). Umgekehrt können neue architektonische Konzepte (2. Ordnung) wie Contract-first Design Veränderungen am Produktionsprozess (3. Ordnung) nach sich ziehen.

Für unterschätzt halte ich in jedem Fall den Veränderungsdruck von innen, der durch "Massezuwachs" (oder Komplexitätszuwachs) über die Lebenszeit eines Projektes entsteht. Und der Druck, den immer knappere Zeitvorgaben und volatile Kundenwünsche ausüben, schlägt sich noch nicht in angemessenen Änderungen der Ordnung 2-4 nieder.

Die Übersetzung von Druckwahrnehmung (wie bewusst oder unbewusst auch immer) in Veränderungen unterschiedlicher Ordnung geht also oft schief.

Samstag, 16. Februar 2008

Ordnungsaspekte für das Multithreading [OOP 2008]

Auf der VSone 2008 habe ich gerade einen Vortrag über Software Transactional Memory (STM) gehalten und meine Open Source Implementation NSTM vorgestellt. Der Vortrag war gut besucht; das hat mich sehr gefreut und ermutigt, weiter an NSTM zu arbeiten. Ein wenig Hilfe von anderen Entwicklern wäre dabei natürlich schön... Bei den Collections, die für einen STM neu entwickelt werden müssen, ist einiges zu tun. (Vom .NET Fx angebotene Collections wie List<T> oder Queue<T> können nicht einfach "von außen" transaktional gemacht werden, da ihre internen Strukturen nicht auf STM basieren. Nur eine grundsätzliche thread-safety lässt sich von außen durch pauschale Sperren herstellen.)

Nun finde ich Ordnung/Überblick immer gut. Deshalb habe ich mich gefreut, beim Blick auf die VSone Agenda eine persönliche Erkenntnis gehabt zu haben. Da war nämlich nicht nur ich mit einem Multithreading-Vortrag vertreten, sondern auch Bernd Marquardt zum Thema OpenMP. Dazu kommt noch, dass ich neulich ein wenig über Microsofts Concurrency Coordination Runtime (CCR) gelesen hatte.

Meine Erkenntnis war nun, dass ich in diesen/zwischen diesen Technologien ein Muster erkannt habe. Und Muster als Strukturierungen der Realität finde ich immer gut. Die erzeugen in mir immer ein Gefühl von Entspannung und Aha nach dem Motto "Achsoooo, so ist das! Eigentlich ganz einfach..." :-)

Das Muster, das ich nun gesehen habe, betrifft die Einteilung von Multithreading-Themen. Herb Sutter hat ja auch schonmal eine Einteilung in "The Pillars of Concurrency" gemacht. Die gliedert die Parallelverarbeitung nach Zwecken. Das ist aber nur eine mögliche Dimension, finde ich. Eine andere ist die Einteilung nach "technischen Aspekten".

Für mich teilt sich Multithreading danach auf in drei grundsätzliche Problembereiche:

  1. Code auf Threads verteilen: Code in einem eigenen Thread laufen zu lassen, kann so einfach sein, wie ThreadPool.QueueUserWorkItem() aufzurufen. Zum ersten Aspekt des Multithreading gehört aber mehr. Denn Code explizit auf Threads zu verteilen ist letztlich umständlich oder gar eine intellektuelle Herausforderung. Viel effizienter wäre es doch, wenn Sie sich über die Parallelisierung von Code gar keine Gedanken machen müssten. Mit implizitem oder zumindest deklarativem Multithreading wäre Ihnen eine Last genommen. OpenMP oder Active C# sind dafür hilfreiche Technologien. Mit ihnen erzeugen Sie Threads nicht mehr explizit im Code, sondern sagen viel pauschaler "Hier soll etwas automatisch parallel laufen. Irgendwie."
  2. Parallelen Code koordinieren: Paralleler Code läuft selten isoliert. Er muss vielmehr in seinen Aktivitäten koordiniert werden. Threads müssen sich abstimmen, in dem was sie tun. Sie wollen einander Aufforderungen schicken oder aufeinander warten. Der .NET Fx bietet dafür z.B. WaitHandle verschiedener Art. Aber andere Technologien machen es noch einfacher, z.B. die Ports der CCr oder Protokolle in Active C#. Ganz allgemein geht es bei der Koordinierung immer um Signale in Warteschlangen, auf die man warten kann.
  3. Gemeinsame Ressourcen parallel nutzen: Wenn Threads dann laufen und sich koordinieren, womit arbeiten Sie dann? Häufig auf gemeinsamen Ressourcen. Die können sie aber nicht einfach so ohne Beachtung der anderen Threads egoistisch nutzen! Parallele Nutzung gemeinsamer Ressourcen läuft immer Gefahr, Inkonsistenzen zu erzeugen  - wenn sie sich nicht koordiniert. Koordinationstechnologien helfen also bei der gemeinsamen Ressourcenutzung. Aber eigentlich ist explizite Koordination genauso ineffizient wie explizite Parallelisierung. Auch hier ist also Abhilfe gefordert. Software Transactional Memory oder auch Space Based Collaboration sind Ansätze, die die Parallelnutzung leichter machen. Sie bieten Abstraktionen, hinter denen konkurrierende Zugriffe und ihre explizite Koordination verschwinden.

Wenn ich zukünftig irgendwo etwas über Multithreading lese, dann werde ich mich sofort fragen, um welchen dieser drei Aspekte es dabei geht. Irgendwie ordnet sich für mich dadurch das Thema besser als bisher.

Und ich habe damit Oberbegriffe in der Hand, die ich auch auf Herb Sutters Zwecke anwenden kann. Wie ist´s z.B. mit der Skalierbarkeit? Welche Aspekte haben Einfluss auf sie? Größere Skalierbarkeit ergibt sich z.B. immer durch weniger Koordination und weniger gemeinsame Ressourcen. Oder wie ist´s mit Responsiveness? Dafür ist es vor allem wichtig, Code einfach parallelisieren zu können. Dann nutze ich Parallelität nämlich eher, um responsive zu bleiben.

Würde mich freuen, wenn diese Aspekte Ihnen auch ein wenig helfen würden, die Multithreading-Welt "geordneter" zu sehen.

Dienstag, 12. Februar 2008

Space Based Collaboration - Jetzt mit mehr Öffentlichkeit

So langsam nimmt die WCF-Alternative doch Fahrt auf. Oder besser: die nächste Abstraktionsstufe oberhalb von WCF. Vor ein paar Jahren waren Spaces nur eine recht akademische Idee. Jetzt aber finden sie den Weg in die Öffentlichkeit. Der Beginn eines neuen Paradigmas.

Neulich hatte ich schon ein paar Gedanken zu einer Technologie nach bzw. komplementär zu WCF geäußert. In die selbe Richtung gingen davor auch schon meine Spekulationen über eine neue Klasse von Anwendungen: serverless real-time online collaborative (SROC) applications. Die scheinen nämlich von Spaces als Grundlage für die Kollaboration besonders profitieren zu können.

Als ich 2006 schon einmal über "Life Beyond WCF" und Virtual Shared Memory geblogt hatte, waren Spaces auch noch weniger greifbar. Aber nun hat Amazon einen Tuple Space in die Öffentlichkeit entlassen - mehr dazu in einige Postings in meinem englischen Blog - und das rennomierte Portal "The Serverside" hat (mithilfe des Space-Produktanbieters GigaSpaces) ein eigenes Knowledge Center zum Thema aus der Taufe gehoben. Das machen die ja nicht, wenn da kein Potenzial wäre.

Alles sehr schöne Entwicklungen wie ich finde :-) Weiter ermutigt hat mich auch ein Abend bei der .NET User Group Hamburg: Da habe ich neulich 2,5 Stunden eine Space Implementation diskutiert und demonstriert - und die Teilnehmer waren sehr interessiert bei der Sache. Die Aussicht, eine Alternative zu WCF auf höherem Abstraktionsniveau in die Hände zu bekommen, fanden fast alle sehr attraktiv. Ein besonderer Glücksmoment war dann, als ein Teilnehmer zu dem Chat-Beispiel, das ich live gebastelt hatte sagte, das sei der kürzeste Code für die Chat-Funktionalität, den er je gesehen hätte. Seufz... genau das wollte ich nämlich rüberbringen: Space Based Collaboration macht Code für die Kommunikation in verteilten Anwendungen kürzer und leichter zu lesen und intuitiver.

image

Nach so positivem Feedback aus der User Group freue ich mich nun, das Team hinter der Implementation auch einmal zeigen zu können. Es hat jetzt nämlich selbst eine Presseveröffentlichung herausgegeben und ist online mit einer Projektbeschreibung zu finden. Rechts zu sehen die Helden der XcoSpaces, der .NET-Implementierung der Space Based Collaboration: Prof. Eva Kühn (vorne rechts) ist die Initiatorin und Koordinatorin des Projektes und unermüdliche Verfechterin des Space-Paradigmas seit vielen Jahren; und Thomas Scheller (vorne links) zusammen Markus Karolus (dahinter) haben die XcoSpaces tapfer implementiert. Es macht Spaß, mit dem Team an der Idee zu arbeiten und sie aus der akademischen in die praktische .NET-Welt zu tragen.

Wer nun neugierig geworden ist, was es denn mit Spaces auf sich hat, der melde sich gern bei mir via Email oder per Blog-Kommentar. Der XcoSpaces-Prototyp zweiter Generation ist für Interessenten kostenlos erhältlich. Eva Kühn et al. und ich sind sehr daran interessiert, Erfahrung im Einsatz von Spaces in realen Problemszenarien zu sammeln.

Donnerstag, 31. Januar 2008

Was kommt nach WCF? Gedanken über die Grenzen der Nachrichtenorientierung

Um es gleich vorweg zu sagen: Ich find WCF schon toll. Aber - und dieses aber ist mir wichtig - WCF lässt in mir kein Gefühl von "angekommen sein" entstehen.

Toll an WCF ist die Vereinheitlichung, die es erreicht hat. COM+/Enterprise Services, .NET Remoting, Web Services und MSMQ sind in WCF zu einem konsolidierten Programmier- und Kommunikationsmodell zusammengeflossen. Äußerlich ist der Unterschied zwar marginal - es werden wie seit der Erfindung von RPC immer noch entfernte Funktionen direkt aufgerufen. Doch die konsequente Nachrichtenorientierung ist der Natur entfernter Kommunikation wesentlich angemessener als die bisherigen Versuche der Objektorientierung, ihren Siegeszug bei der in-process Kopplung von Codeeinheiten auch auf die cross-process oder gar cross-platform Kopplung auszudehnen. Corba, EJB, .NET Remoting heißen diese letztlich gescheiterten Versuche. RIP.

Also: WCF ist toll. Und doch...

Es will sich bei mir kein wohliges Gefühl der Zufriedenheit einstellen. Die Vereinheitlichung ist mir irgendwie nicht genug. Vereinheitlichung war zwar ein wichtiges Ziel, ebenso der konsequente Abschied von "verteilten Objekten" - aber ist WCF deshalb gleich das Ideal? WCF ist vielleicht der beste vereinheitlichte nachrichtenorientierte API, den es gibt.  Aber wollen wir eigentlich Nachrichtenorientierung? Ist funktionsbasierte Nachrichtenorientierung als einziges Kommunikationsmodell zwischen verteilten Codeeinheiten wirklich das wünschenswerte Abstraktionsniveau?

Ich werde das Gefühl nicht los, dass "es" noch anders gehen könnte und sollte. Zumindest als Alternative, wenn nicht als pauschaler Ersatz für WCF. Um das Gefühl mal zu konkretisieren, hier einige Punkte, die mir bei WCF aufstoßen. Lobeshymnen hören wir ja häufig genug. Also:

  • WCF ist unehrlich
  • WCF ist anti-autonom
  • WCF ist kompliziert
  • WCF ist starr
  • WCF ist unintuitiv

So ganz allein stehe ich mit meiner Meinung, dass WCF bzw. allgemeiner die Nachrichtenorientierung irgendwie noch nicht das Ende der Fahnenstange sein kann, wohl auch nicht. Das renommierte Portal "The Service Side" (TSS) hat gerade ein "Space Based Architecture Knowledge Center" eingerichtet und Amazon hat unlängst einen Tuple Space (SimpleDB) als Beta in sein SaaS-Angebot gehoben. (Mehr zum Thema SimpleDB in bei meinem Open Source Projekt NSimpleDB.)

Spaces - so die Botschaft von TSS (mithilfe des Infrastrukturanbieters Gigaspaces) und Amazon - sind eine Alternative zur Nachrichtenorientierung. Spaces und Räume statt der ewigen Röhren. Warum nicht? Dem Gedanken bin ich sehr zugetan. Deshalb bastle ich mit an einem "Space-Angebot" - das aber noch eine Weile bis zum großen Auftritt brauchen wird. Deshalb habe ich das SimpleDB Datenmodell mit NSimpleDB auf den Desktop gebracht, um es leichter für Experimente verfügbar zu machen. Denn Experimente sind noch nötig, um die Reichweite des Space-Paradigmas abzustecken. In dieser Linie sehe ich auch dieses Posting: Als ein lautes Nachdenken über Space Based Architecture (SBA) oder Space Based Computing (SBC) oder Space Based Collaboration (SBC), mit dem ich mir selbst wieder ein Stückchen klarer über Nutzen und Grenzen von SBC/SBA werde. Ein probater Anfang ist dafür wie immer, mal die "pain points" zu benennen, wo mich das Existierende sticht.

WCF ist aus meiner Sicht unehrlich, weil ich die Syntax des Methodenaufrufs für das falsche Mittel halte, um einen Auftrag an eine entfernte Codeeinheit zu übermitteln. Einer Anweisung wie

resp = service.TueEtwas(req);

kann ich nicht ansehen, ob der Service lokal oder remote läuft. Läuft er aber remote, dann leistet die Syntax den vielzitierten "Fallacies of Distributed Computing" massiven Vorschub. Das halte ich für essenziell nachteilig im Hinblick auf Wartbarkei und Verständlichkeit und womöglich auch Skalierbarkeit und Performance. Ausführlich habe ich diesen Gedanken in einem Beitrag [PDF] für "SOA Expertenwissen" dargelegt.

In dem Beitrag erkläre ich auch, warum diese Form der "Auftragsübermittlung" für mich grundlegend anti-autonom ist. Sie formuliert einen Befehl, dessen syntaktische Form danach heischt, sofort ausgeführt zu werden. Sofortigkeit steht jedoch zum Einen im Widerspruch zur physikalischen Realität der Verteilung von Client und Service, zum Anderen ist sie aber auch unvereinbar mit dem simplen Hauptgrund einer Verteilung überhaupt: Autonomität. Verteilte Codeeinheiten sind verteilt, damit sie möglichst autonom über ihre Prozesse und Ressourcen entscheiden können. Wer jedoch autonom ist, der will sich nicht vorschreiben lassen, wann und wie genau er einen Dienstleistungswunsch erfüllt. Solchen Freiraum bietet die Form der Nachrichtenorientierung in WCF jedoch nicht.

Nun mag man das alles für Haarspalterei halten. Das fände ich zwar schade, weil Form und Funktion, Syntax und Semantik in einem Gleichklang stehen sollten. Wenn sich die Funktionsweise in der Form widerspiegelt, wenn klar erkennbar ist, wie etwas funktioniert, dann ist das Bild kohärent und wirkmächtiger. Dann ist weniger Raum für Missverständnisse.

Aber sei´s drum. Deshalb hier zwei hoffentlich handfestere Kritikpunkte: Ich finde WCF recht einfach für Allereinfachstes, aber kompliziert für sehr Typisches. Typisch sind für mich z.B. die asynchrone Benachrichtigung über Ereignisse in einem Service, typisch sind für mich daraus folgende Aufrufe des Service. Beides ist natürlich mit WCF möglich. Aber ich finde es recht kompliziert. Für eine simple Notifikation muss ich plötzlich über Duplexkommunikation nachdenken und ein Rückrufinterface registrieren. Und wenn ich dann in so einem Event den Service aufrufen möchte, dann geht es plötzlich um Reentrancy. Das kann man alles lernen. Klar. Aber das ist so typisch, dass ich den Lernaufwand und damit die Gefahr, etwas falsch zu machen, für zu groß halte.

Kompliziert wird es auch, wenn meine Services nicht (nur) an einer Adresse zu erreichen sind. WCF verlangt ja, dass ich die Adresse einer Dienstleistung festlege. Das finde ich starr. Reicht das starre Schema aber nicht, weil ich Mobilität oder Fehlertoleranz haben möchte, dann muss ich Klimmzüge machen oder gar orthogonal zu WCF mit Infrastruktur wie Clusterservern anfangen. Geht alles - aber könnte einfacher sein, finde ich.

Kollaboration statt Kommandoton

Schließlich: Mit WCF kann ich Nachrichten zwischen zwischen Parteien austauschen. Aber ist das Leben denn immer Nachrichtenaustausch, direkter Nachrichtenaustausch? Wer gewohnt ist, im Kommandoton zu sprechen und sofortige Ausführung erwartet, der ist mit Nachrichtenaustausch von oben nach unten in der Befehlshierarchie sicherlich zufrieden. Doch selbst das Militär hat inzwischen erkannt, dass sich mit Gehorsam allein kein Krieg gewinnen lässt. Krieg und Geschäftsleben, beide sind so dynamisch, dass autonome Entscheidungen ohne expliziten Befehl ganz vorne an der Front wichtig sind. Und Kriegsführung wie Geschäftsführung setzen daher auf Kollaboration statt Kommandoton, wenn´s darauf ankommt, wirklich etwas gebacken zu bekommen.

Kollaboration, d.h. selbstständige Zusammenarbeit an etwas Gemeinsamem, ist auch die natürlichste Arbeitsform. Dabei zwingt nicht der eine Kollaborateur den anderen, ihm - hopp! - einen Dienst zu leisten, sondern wünscht sich das sozusagen indirekt. In der Kollaboration ist Asynchronizität der vorherrschende "Antwortmodus" und Aufgaben werden "ausgeschrieben". Kollaborateure stehen um ein (mehr oder weniger handfestes) Medium herum, auf das sie gemeinsam blicken. Das kann ein Arbeitsplan sein, eine Geländekarte, eine Bauwerk, ein Tisch voll mit CRC-Cards, eine Inbox auf dem Schreibtisch oder auch ein Spielbrett. An diesem Medium arbeiten die Kollaborateure gemeinsam, damit bzw. daran teilen sie sich Aufgaben zu. Jeder behält dabei seine Autonomität, beobachtet das gemeinsame Medium, manipuliert das gemeinsame Medium. Und die von allen anerkannten Regeln, wie mit dem Medium umgegangen werden darf, sorgen dafür, dass die Kollaborateure trotz ihrer Autonomität einem gemeinsamem Ziel zustreben.

Also: Wo die Aktivitäten von autonomen Einheiten koordiniert werden sollen, geschieht das oft über einen "runden Tisch", ein gemeinsames Medium, um das sich alle versammeln. Da WCF nun eine Technologie ist, die die Zusammenarbeit von Codeeinheiten befördern will, liegt deshalb die Frage nahe, ob WCF jenseits des Kommandotons entfernter Serviceaufrufe auf die Kollaboration mittels gemeinsamen Mediums beherrscht? Die Antwort lautet nein. Für WCF ist die Arbeit an gemeinsamen Datenstrukturen kein Thema. Und genau das halte ich für ein großes Manko. Das macht WCF nämlich unintuitiv für den Einsatz in vielen Verteilungsszenarien. Schon ein simpler Chat oder ein verteiltes Spiel sind dafür gute Beispiele: Chat und Spiel (z.B. TicTacToe) sind triviale Kollaborationsaufgaben, bei denen die Beteiligten an einfachen Datenstrukturen gemeinsam arbeiten. Beim Chat ist das eine Liste von Nachrichten, beim Spiel ein zweidimensionales Array (Spielfeld). Von einer Technologie, die die Entwicklung verteilter Anwendungen erleichtern will, erwarte ich nun, dass sie mich auch unterstützt, diese natürliche Sichtweise im Code abzubilden. Das tut WCF aber nicht. Für WCF gibt es keine gemeinsame Liste, kein gemeinsames Spielfeld. WCF sagt: "Sieh zu, wie du es mit gegenseitig zugerufenen Befehlen hinbekommst, dass jeder Beteiligter denkt, es gäbe die gemeinsame Datenstruktur."

Das ist natürlich absolut legitim. Wenn WCF sich mit gemeinsamen, verteilten Datenstrukturen nicht abgeben will, dann ist das eine klare Aussage. Aber es bleibt dadurch eben auch eine Lücke. Manche oder womöglich eine ständig wachsende Zahl von Anwendungen haben es trotz WCF schwer. Bei ihnen geht es "nur" um Kollaboration und gleich eine Datenbank als gemeinsame Struktur aufzusetzen, wäre für sie Overkill. Kollaborationsinformationen sind oft nur kurzzeitig relevant.

Mit mehr Abstraktion in die Zukunft

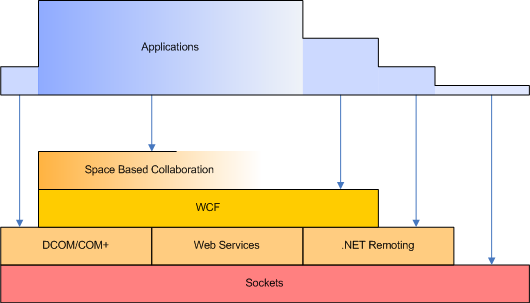
Für mich ergibt sich damit ein "Wunschbild" wie folgt:

image

Der Stack der Kommunikationstechnologien wäschst weiter. Muss weiter wachsen. Alte Technologien werden nicht einfach ersetzt, sondern in der Relevanz nur zurückgedrängt. Es wird weiterhin Anwendungen geben, die direkt via Sockets kommunizieren müssen. Und das ist ok. Auch wird es Szenarien geben, in denen .NET Remoting Stärken gegenüber WCF ausspielt, d.h. entfernte Objekte gegenüber der  Nachrichtenorientierung einfach Abstraktionsvorteile bieten. Und warum auch nicht? Nachrichtenorientierung mit WCF wird natürlich auch ihren Platz haben. Keine Frage. Aber ich glaube, Nachrichtenorientierung tut gut daran, ihren Alleinherrschaftsanspruch über die Kommunikation in verteilten Anwendungen aufzugeben. Nachrichtenorientierung ist nicht das Gipfelkreuz auf dem Abstraktionsberg, sondern allenfalls ein Lager in großer Höhe.

Und was kommt nach bzw. oberhalb von WCF? Mein Tipp: Space Based Collaboration. Spaces sind nach 20 Jahren Forschung und kommerziellen Anläufen reif für die breite Masse. Performance und Netzwerkverfügbarkeiten sind hoch genug, um ihre Ansprüche befriedigen zu können. Abstraktion kostet ja immer etwas.

Aber Abstraktion bringt vor allem immer etwas: weniger Kopfschmerzen. Das halte ich für erstrebenswert. WCF ist gut und notwendig. Aber verteilte Anwendungen der unterschiedlichsten Art und Größe - von cross-thread Kommunikation bis global cross-platform Kommunikation - dürfen gern noch viel einfacher zu bauen sein. Spaces bieten da, meine Meinung nach, ein schönes und überfälliges Daten-/Programmiermodell. Denken in Räumen und Datenstrukturen, statt in Nachrichten und Röhren.

Tuple Spaces, JavaSpaces, GigaSpaces, SimpleDB... das ist erst der Anfang. Stay tuned!

Montag, 28. Januar 2008

Kommentare weg :-(

An die fleißigen Kommentarschreiber zu diesem Blog: Durch unachtsames Herumspielen mit den Einstellungen des Blogs bin ich zunächst über neue Kommentare einige Wochen nicht informiert worden - und habe sie mir dann heute auch noch beim Veröffentlichen in letzter Sekunde durch einen einzigen falschen Klick weggeschossen :-( Sorry! Ich gelobe Besserung. Jetzt sollte der Prozess aber wieder funktionieren.

Auf ein Neues also? Ich würde mich freuen.

Amazons SimpleDB at your fingertips

Dass ich an einer Open Source Implementation (NSimpleDB) von Amazons SimpleDB Datenmodell und API sitze, hatte ich ja schon berichtet. Bisher lief das Ganze allerdings nur lokal. Aber das war ok, denn ich wollte ja zunächst auch nur eine lokale Version zum Herumspielen für diejenigen, die noch keinen Zugang zum SimpleDB Betaprogramm bekommen hatten bzw. die, die einen so einfachen Datenbank-API für die Persistenz einfach auch lokal einsetzen wollen.

Nun habe ich inzwischen jedoch selbst Zugang zur SimpleDB Beta bekommen. Deshalb war es mir natürlich ein Anliegen, den Umgang mit Amazons online Tuple Space in meine Implementation zu integrieren. Da mein eigenes API-Serviceinterface ISimpleDBService schon "serviceorientiert", d.h. für eine Benutzung als Remote-Schnittstelle ausgelegt war, stellte das nun auch kein Problem dar.

Über dasselbe Interface lassen sich also nun sowohl Daten lokal wie online nach dem Amazon SimpleDB Datenmodell speichern und abfragen. Bisher ging das so lokal:

ISimpleDBService ts;

ts = new NSimpleDB.Service.VistaDb.VistaDbSimpleDBService("hello.ts");

...

ts.Close();


Aber jetzt geht es auch so:

ts = new NSimpleDB.Service.Amazon.AmazonSimpleDBService("<accessKeyId>", "<secretAccessKey>");

Einfach die AmazonSimpleDBService Implementation instanzieren, die von Amazon Ihrem AWS-Konto zugewiesenen Keys übergeben, fertig. An den sonstigen Operationen auf ISimpleDBService ist nichts zu ändern. Noch etwas mehr dazu in meinem englischen Blog.

Ich finde mein Interface für das Amazon Datenmodell ziemlich gradlinig. Etwas objektorientierter könnte es zwar noch hier und da sein, aber dennoch leicht zu bedienen. Für einen remote service passt es aber erstmal so, würde ich sagen. Wer damit herumspielen mag, kann von meinem NSimpleDB Open Source Projekt bei Google Code auch eine fertig übersetzte Assembly inkl. Demoprogramm herunterladen.

Montag, 21. Januar 2008

OOP 2008: Die Datenbank in den Wolken - Amazons SimpleDB

Wir kennen alle die Vorteile der RDBMS-Schwergewichte in unseren lokalen Netzen. Aber das Bild ist nicht ungetrübt. Unternehmensweit zugängliche Datenbanken machen Deploymentaufwand, kosten viel in der Administration und sind in ihren Schemata vergleichsweise starr. Das wird in einer immer mehr auf Vernetzung und Dynamik setzenden Geschäfts-/Softwarewelt zunehmend zum Problem. Aber wo ist die Lösung?

Natürlich gibt es nicht nur eine Lösung, sondern viele für unterschiedliche Szenarien. Manchmal reicht eine embedded database wie TurboDb oder VistaDb, manchmal ist eine objektorientierte Datenbank wie db4o angebracht, manchmal bringt ein Data Warehouse die Lösung.

Und nun bietet Amazon, die schon lange nicht nur Bücher verkaufen, sondern auch Web Services im Programm haben, eine weitere Datenbankoption: SimpleDB.

SimpleDB ist eine online Datenbank, die Sie per Web Service ansprechen können. Jeder Deploymentaufwand entfällt also. Und bei 100 MBit-Internetverbindungen, wie sie heute schon Privathaushalten für kleines Geld zur Verfügung stehen, ist es vom Geschwindigkeitsaspekt her letztlich nicht mehr so wichtig, ob eine Datenbank im LAN oder "in the cloud" liegt.

Wenn Sie einmal überlegen, wieviel Aufwand Sie bisher betrieben haben, um nur eine simple Datenspeicherung irgendwie im Internet, also weltweit zentral verfügbar, zu realisieren, dann können Sie das Potenzial erahnen, das in SimpleDB steckt. Gerade für die gemeinsame Nutzung von Daten über LAN-/Unternehmensgrenzen hinweg sind SimpleDB und die anderen Amazon Web Services wie S3 (Speicherung großer Datenmengen/Blobs) und SQS (Kommunikation via Warteschlangen) a godsend.

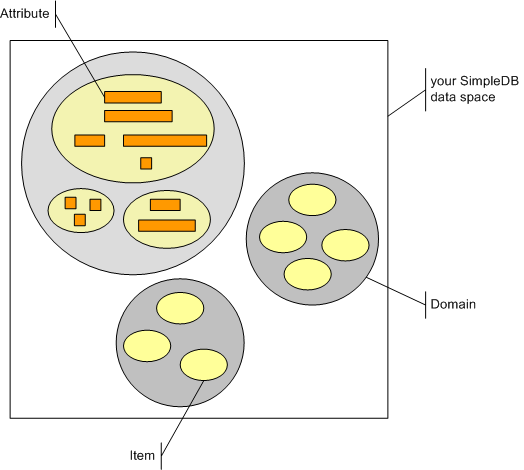
SimpleDB ist derzeit allerdings nur als Beta-Version verfügbar. Das Featureset ist also noch im Fluss. Dennoch ist es schon jetzt vielversprechend und spannend. Denn Amazon bewegt sich abseits des üblichen RDBMS-Pfades. SimpleDB implementiert nicht das relationale Datenmodell, sondern einen Tuple Space. Darin gibt es keine Tabellen mit Datensätzen, sondern so genannte Domains mit Items als Tuple:

image

Und die Tuple innerhalb einer Domain müssen keinem festgelegten Schema folgen. Und ihre Attribute können sogar mehrere Werte enthalten.

Das alles ist ganz anders als die vertraute RDBMS-Welt. Aber es ist vielversprechend, weil es einen viel dynamischeren Umgang mit Daten erlaubt. Wenn Datenbanken Verträge zwischen Applikationen sind und Applikationen, die über das Internet verbunden sind, sich nicht synchron verändern, dann ist es wichtig, dass ihre Verträge elastisch sind. Sie müssen eine wachsende Zahl von Bedürfnissen befriedigen. Ein fixes Schema wäre da kontraproduktiv. Amazons SimpleDB ist daher eine "Klebstoffdatenbank", die heterogene und/oder stark fluktuierende Parteien verbindet. Ihr Fokus ist die Flexibilität, nicht die Effizienz.

SimpleDB im lokalen Netz

Angesichts einer limitierten Anzahl von Beta-Konten für SimpleDB und dem Wunsch, das SimpleDB-Datenmodell mit seinem API nicht nur im Internet nutzen zu können, habe ich entschlossen, SimpleDB in einer Desktopvariante zu entwickeln. Die .NET SimpleDB (NSimpleDB) ist das Ergebnis. NSimpleDB bietet die Leistungen von SimpleDB in Form einer "embeddable tuple space engine". Sie können mit NSimpleDB im lokalen Netz so umgehen, wie mit SimpleDB im Internet. Das ist performanter, das ist kostengünstiger (weil SimpleDB am Ende ein kostenpflichtiger, wenn auch sehr günstiger Service ist), das ist auch mobil möglich, das ist einfacher.

NSimpleDB ist ein Open Source Projekt entwickelt in C#. Ich hoste den Code bei Google. Wer ihn selbst übersetzen will, ist dazu herzlich eingeladen. Mit Subversion können Sie ihn herunterladen. Wer dagegen nur eine fertige Komponente nutzen möchte, kann das auch. Ich habe ein kleines Beispielprogramm zum Download bereitgestellt; darin ist NSimpleDB.dll enthalten. Nur die Assembly ist nötig, um mit dem SimpleDB Datenmodell zu experimentieren.

Mehr über SimpleDB und den Umgang mit NSimpleDB erfahren Sie in meinem englischen Blog. Dort finden Sie eine mehrteilige Artikelserie zum Thema.

Über Feedback jeder Art würde ich mich freuen.