Follow my new blog

Donnerstag, 10. Januar 2008

OOP 2008: Zurück zum Papier - Leseempfehlungen für 2008

image Das gute, alte Papier hat mich wieder.

Ich habe gerade ein Abo der "Traditionszeitschrift" aller Softwareentwickler bestellt, dem Dr Dobb´s Journal. Nicht obwohl, sondern weil es nicht .NET-lastig ist. image


Und dann habe ich heute gleich noch ein Abo des in Deutschland recht unbekannten, aber nicht minder guten CoDe Magazines drauf gelegt. Das bietet immer wieder sehr gute Artikel zum Thema .NET.

 imageNeulich hat es mich auch überkommen und ich habe endlich auch das MSDN Magazine, die Entwicklerpostille von Microsoft, geordert. Die gibt es zwar auch monatlich kostenlos im Internet - aber was soll´s? Der USD steht grad so günstig.

Und völlig im Rausch habe ich mir Ende 2007 dann auch noch - quasi als Weihnachtsgeschenk - eine Mitgliedschaft bei der "Association of Computing Machinery" (ACM) gegönnt. Die haben ein exzellentes online Archiv wissenschaftlicher Artikel zu allen Informatikthemen der letzten Jahrzehnte. Da findet sich immer mal wieder sehr interessantes Hintergrundmaterial. Damit lege ich sozusagen mein Ohr an die Grasnarbe der Informatik. Das ist der ultimative Blick über den Tellerrand in die Forschung hinein. image Die ACM-Hauszeitschrift "Communications of the ACM" bringt mir jeden Monat einen bunten Blumenstrauß an Themen ins Haus, die ich in den anderen sehr praxislastigen Publikationen nicht finde.

Aber damit nicht genug! Das sind ja nur meine neuesten Zeitschriftenerrungenschaften. Ohnehin schiebt mir der Postbote jeden Monat die dotnetpro, das dot.net Magazin und das OBJEKTspektrum durch den Schlitz. Und um auch mal etwas ganz anderes zu lesen, lasse ich auch noch brandeins jeden Monat in meinen Postkasten brummen.

image image image image

Puh. Ganz schön viel zu lesen. (Ganz zu schweigen von den Bücherbergen an meinem Nachttisch...) Aber so spannend, so interessant. Naja, nicht immer alles in allen Publikationen... Aber genug, um durchgängige alle zu beziehen.

Damit komme ich zu meiner neuen Lesegewohnheit Nr. 1 für 2008: Ich werde konsequent nur noch das lesen, was 1. für mich relevant ist, d.h. zu meinen Arbeitsschwerpunkten .NET-Softwarearchitektur/-Test/-Softwareproduktion und "Softwarekollaboration" gehört. Darüber hinaus lese ich dann noch das, was 2. mein Interesse auf den ersten Blick erregt. Und das meine ich so: auf den ersten Blick. Ich werde mich nicht reinknien und lange überlegen, ob ich etwas lesen sollte, sondern zur Abwechslung mal mein Gefühl entscheiden lassen ;-)

Daraus ergibt sich dann direkt meine neue Lesegewohnheit Nr. 2: Ich beende die Lektüre einer Zeitschrift, wenn ich alle Artikel gem. Lesegewohnheit Nr. 1 gelesen habe. Dabei ist es egal, ob das 2 von 20 oder 18 von 20 waren. Ich habe keine Skrupel mehr, fast ungelesene Zeitschriften wegzuschmeißen. Insbesondere die wunderbaren online Archive von dotnetpro, Dr. Dobb´s, MSDN Magazine, CoDe Magazine, CACM und brandeins machen es mir leicht, die Zeitschriften wirklich in den Müll zu tun, statt Regalmeter damit zu füllen.

So erklärt sich auch meine Lesegewohnheit Nr. 3: Falls ich aus irgendeinem Grund selbst die nach Nr. 1 ausgewählten Artikel nicht bis zur nächsten Ausgabe geschafft haben sollte, dann schmeiße ich die Zeitschrift trotzdem weg. In diesem Punkt habe ich lange mit mir gerungen. Es schien mir nicht respektvoll gegenüber den Publikationen, sie nicht zu lesen, wenn ich sie schon habe. Und ich hatte das latente Gefühl, etwas zu verpassen. Aber beide Gefühle habe ich nun aufgegeben. Sie entstammen einer langen Prägung durch Mangel, wie er im Grunde immer herrschte - bis heute. Noch bis Ende der 1990er haben wir an Informationsmangel der einen oder anderen Art gelitten. Aber das ist nun endgültig vorbei.

Weder bin nicht respektvoll gegenüber den Publikationen, denn sie sind ja auch, wenn das Papier schon im Mülleimer ist, immer noch online zugänglich. (Naja, alle bis auf zwei ;-) Ich schmeiße also nur eine Manifestation der Arbeit der Autoren in den Müll, nicht deren Arbeit. Auf die kann ich weiterhin zugreifen.

Und auch das Gefühl des Verpassens ist überflüssig. Denn erstens kann ich alles in den online Archiven dann doch noch lesen. Ich verpasse höchstens etwas auf Papier. Zweitens aber - und das ist die für mich viel wichtigere Erkenntnis - ist heute nicht mehr der Artikel A in Ausgabe N der Zeitschrift Z wichtig. Er mag interessant sein, aber nicht wichtig. Denn angesichts des Contentüberflüsses, in dem wir heute bis zum Hals stehen, sind Themen nicht mehr mit einzelnen Veröffentlichungen gleichgesetzt. Klar, es mag ein Thema besonders gut in einer bestimmten Veröffentlichung behandelt sein. Eine konkrete Veröffentlichung ist natürlich auch immer die erste, die ein Thema aufreißt. Aber durch die Veröffentlichungsflut ist gewährleistet, dass wirklich wichtige Themen (langsam, aber sicher) auch zu mehreren Veröffentlichungen führen. Ich kann sie also auf Dauer nicht übersehen.

Insofern lehne ich mich ganz beruhigt zurück und vertraue auf Lesegewohnheit Nr. 1. Damit bleibe ich zu meinen Themen auf dem Laufenden. Und ich habe die Garantie, auch auf Inspirationen zu stoßen. Wenn nicht in dieser Ausgabe, dann in der nächsten oder übernächsten... Es gibt keinen Mangel an Inspirationsquellen. Also muss ich sie nicht suchen und sammeln, sondern kann mich an ihnen laben, wenn mir danach ist. Und da vertraue ich mal auf mein Gefühl beim ersten Blick.

Jetzt noch zu Lesegewohnheit Nr. 4: Ich lese wieder mehr auf Papier. Am PC lesen ist nett für das ad hoc Lesen, z.B. von Email oder einen Überblick. "Lesen zwischendurch" tue ich gern am PC. In elektronischen Inhalten kann ich leichter suchen und ich kann mich mit Links durch Inhalte hangeln. So kann ich entweder sehr gezielt auf Stoff zugreifen oder genau das Gegenteil tun: mir ein Themenfeld grob erschließen, indem ich wie mit dem Finger auf der Landkarte das Terrain schnell und aus großer Höhe vorerkunde.

imageUm dann aber eine Publikation von mehreren Seiten wirklich zu lesen, brauche ich Papier. Ja, immer noch. So sehr ich ein Freund von online Publikationen bin (ich schreibe ja immerhin auch dieses Block), so ist das Lesen von Publikationen immer noch etwas anderes.

Erstens sind Texte auf Papier immer noch besser zu lesen, als am Bildschirm. Daran ändern auch Amazon´s Kindle und die hübsch wie funktional aufbereitete digitale Ausgabe der CACM nichts.

Zweitens sind Texte auf Papier immer noch mobiler. Sie sind leichter und in der Form flexibler. Ich kann sie in eine kleine Tasche stecken oder am Frühstückstisch lesen. Selbst mit meinem 12" Laptop wäre das mit elektronischen Texten nicht so leicht.

Beide Gründe zusammen genommen - dazu noch der vorteilhafte USD-Kurs - waren für mich nun genug Anlass, das Jahr 2008 mit einer "Abo-Manie" zu beginnen. Denn die Abos liefern mir ohne weiteren Aufwand Inhalte auf Papier für´s leichte Lesen. Ich muss mir keine Gedanken über´s Wegschmeißen machen, da (fast) alle Inhalte auch noch komplett online verfügbar sind. Dafür bezahlte ich auch gern die Abo-Gebühr. Und schließlich ist es angenehmer, eine Zeitschrift in der Hand zu halten, als die ewigen doppelseitigen FinePrint-Ausdrucke.

PS: Ach ja, bevor ich es vergesse, es gibt noch eine Lesegewohnheit Nr. 5: Mehr redaktioneller Inhalt. Ich abonniere in Zukunft weniger Blogs in meinem RSS-Reader. Ein paar werden übrig bleiben von Autoren, die ich schätze und die sich wirklich kontinuierlich Mühe geben. Dazu zähle ich z.B. Jeff Atwood, Joel Spolsky oder Martin Fowler. Für die ist ein Blog keine Nebensache. Sie kippen nicht nur Datenschnippsel ins Internet. Dort findet vielmehr öffentliches Nachdenken über unsere "Kunst" statt. Für "Tipps & Tricks" von einer Produktgruppe in Redmond oder auch zum Thema XYZ abonniere ich kein Blog mehr. Schön, dass es auch solche Blogs gibt - aber für mich ohne Abo. Wenn ich mal Bedarf habe an solchen Inhalten, dann stolpere ich schon mit Google darüber.

Je technischer also ein Blog, desto weniger "abowürdig" ist es für mich. Oder besser: je weniger unmittelbar relevant für meinen Arbeitsschwerpunkt ein Blog ist, desto weniger "abowürdig" ist es. Denn wenn ich den ganzen Tag WinForms-Programmierung machen würde, dann würde ich auch ein technisches WinForms-Blog abonnieren - sofern das Blog für den Autor keine Nebensache ist und er sich Mühe gibt.

Der bewusste Umgang bei der Produktion von Inhalten wird mir immer wichtiger. Der, der produziert, soll mir Arbeit abnehmen, indem er filtert. Das ist insbesondere bei den Zeitschriften der Fall. Also lese ich mehr davon, statt unredigiertes im Web. Dafür ist mir meine Zeit zu schade. Wirklich Wichtiges kann ich ja auch bei den Zeitschriften nicht verpassen (s.o.).

image So, jetzt aber genug für heute. Die Abos sind bestellt... Upps, eines habe ich noch vergessen Microsofts Architektur-Journal zu ordern. Das gibt es kostenlos auf Papier. Vier Mal im Jahr. Da kann ich nicht Nein sagen, oder? ;-)

Freitag, 4. Januar 2008

OOP 2008: Open Source mit kommerziellen Tools - Adé Gewissensbisse

In der letzten Zeit habe ich einige Projekte dank Google Project Hosting ganz einfach in die Open Source Welt einbringen können. Da gibt es zum Beispiel einen Microkernel oder einen Software Transactional Memory oder den Code zu meiner aktuellen dotnetpro Artikelserie über Mustervisualisierung.

Mit dem kostenlosen Subversion kann man den Quellcode von Google herunterladen. Mit dem kostenlosen NUnit kann man die darin befindlichen Unit Tests laufen lassen. Und mit dem kostenlosen C# (oder VB) Express von Microsoft kann man den Code auch übersetzen. Nein, sogar nur mit dem .NET Framework und MSBuild sollte das möglich sein. Insofern haben mich bisher keine Skrupel geplagt, selbst mit einer kostenpflichtigen Visual Studio Version zu arbeiten. Die Nutzung der Quellen ist ja auch mit kostenlosen Tools möglich.

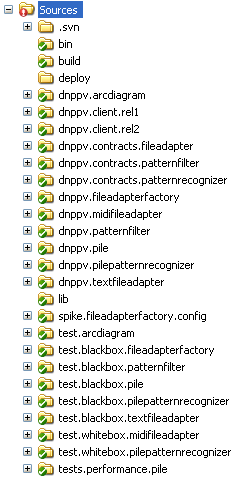
Aber jetzt habe ich doch Gewissensbisse bekommen. Denn jetzt werden die Projekte so groß (oder meine Bequemlichkeitsansprüche sind gewachsen ;-), dass ich sie nach und nach mit einem automatischen Build-Prozess ausstatten will/muss. Den Anfang macht die dotnetpro Mustervisualisierung dnpPatViz. So sieht deren Quellcodebaum aus:

image

Diese vielen Projekte halte ich nicht in nur einer Visual Studio Solution/Projektmappe, denn das ist einer echt komponentenorientierten Entwicklung abträglich. Um schnell einen Überblick über die Gesamtkorrektheit meiner Quellen zu bekommen, kann ich daher nicht einfach F5 in Visual Studio drücken, sondern muss viele Solutions übersetzen und dann eigentlich auch noch alle Tests laufen lassen.

Ganz klar also, dass da ein automatischer Build- und Testprozess her muss. Aber womit den aufsetzen? Mit MSBuild oder NAnt wäre wohl die übliche Antwort aus der Open Source Welt. Die sind ja kostenlos.

Doch dazu kann ich mich wirklich, wirklich nicht überwinden. MSBuild- und NAnt sind kostenlos - aber erfordern geradezu ein Studium. Wie lange soll ich mich denn in deren XML-Dialekte einarbeiten? Wieviel soll ich denn tippen, um mal ein paar Projekte zu übersetzen, zu testen und dann noch zu deployen oder in ein Repository zu laden usw.? Ne, tut mir leid, für solche Klimmzüge ist mir meine Zeit zu schade.

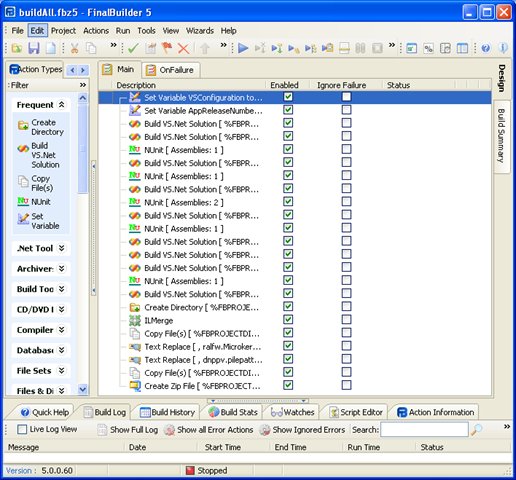
Dabei gibt es doch Alternativen. Die Automatisierung von solchen Alltagstätigkeit und noch ganz anderer Prozesse (z.B. FTP-Upload oder Steuerung einer VM) kann auch viel einfacher sein. Viel einfach! Sie muss auch nicht aus Megabytes von XML-Verhauen bestehen. Sie kann nämlich aussehen, wie ein Workflow. Zum Beispiel so:

image

Das ist das Build-Script für die Mustervisualisierung. Hübsch visuell, intuitiv zu verstehen, leicht zu lesen und ohne eine Zeile Doku zu lesen in wenigen Minuten von der Übersetzung des ersten Visual Studio Projektes über die automatischen Tests bis zum abschließenden ILMerge zusammengesetzt.

Das (!) nenne ich Produktivität.

Und möglich ist´s mit FinalBuilder, einem wirklich coolen Tool. Das kostet zwar ein paar Euro - aber macht nix. Das Geld, was ich bei kostenlosen Tools spare, das habe ich mit FinalBuilder locker, ganz locker schon beim ersten größeren Einsatz wieder reingeholt. Ganz zu schweigen vom nervenschonenden Effekt eines grafischen Tools für "Build Workflows". FinalBuilder ist aus meiner Sicht für den Build-Prozess das, was VB 1.0 mal für die Windows-Entwicklung war. Aber genug des Schwärmens.

Wenn ich oben noch von Gewissensbissen gesprochen habe... dann sind die inzwischen verflogen. Ich habe mich von ihnen verabschiedet und mich entschieden, auch meine Open Source Quellen mit FinalBuilder Scripts auszustatten.

Open Source ist ja auch nur das: Open Source. Es sagt nichts darüber aus, mit welchen Werkzeugen die Open Sources zu bearbeiten sind. Die können von mir aus gern kostenlos sein. Aber wenn ich schon für meinen Entwicklungsaufwand in Form von freien Quellen kein Geld bekomme, dann will ich mich nicht auch noch für Admin-Angelegenheiten oder Organisatorisches verbiegen und durch aufwändige MSBuild-/NAnt-Programmierung draufzahlen.

Kostenlose Quellen: ja. Kostenlose Tools, um mit den Quellen zu arbeiten: nur, sofern der Aufwand den Nutzen nicht übersteigt. Und die Grenze ist aber beim Build-Prozess überschritten. Deshalb habe ich jetzt keine Gewissensbisse mehr. Ein schönes Gefühl.

Montag, 31. Dezember 2007

OOP 2008: Assimilieren statt Speichern - Networking für Daten in einer dynamischen Welt

Alles soll heute flexibel sein: Menschen, die sich auf Jobangebote bewerben, genauso wie Programmiersprachen. Statisch ist out, dynamisch ist in. Nur noch nicht so recht bei den Daten. Denn da regieren Strenge und Statik. Daten werden einmal in Klassen oder Tabellen verpackt - und dann ändert sich diese Anordnung am besten nicht mehr. Falls doch, muss solche Veränderung gut geplant sein, damit die fein ziselierten Datenstrukturen nicht inkonsistent werden.

Datenspeicherung gehört zu einer statischen Welt

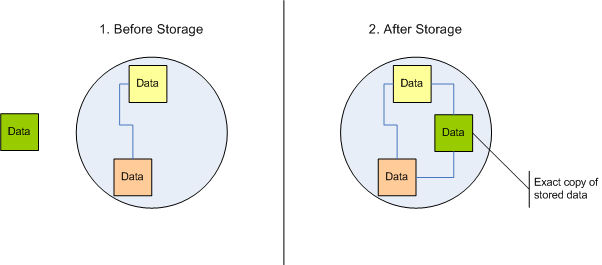
Daten in Container zu verpacken, die einander referenzieren, ist eben ein Informationsmodell für statische Datenstrukturen. Die Daten mögen sich ändern, aber die Strukturen, die Zusammenhängen bleiben konstant. Das ist völlig ok. Allerdings dient das vor allem einem Zweck: der 1:1 Speicherung und Reproduktion von Daten. Das Mittel der Wahl ist dabei das Kopieren dieser Daten. Wenn Sie z.B. Personendaten bestehend aus Vorname+Nachname in einer Datenbank speichern, dann werden die Bytes von Vorname und Nachname mindestens einmal in der Datenbank unverändert abgelegt, wahrscheinlich jedoch mehrfach. Jeder Index multipliziert ja gespeicherte Daten.

image

Dass die Geschichte der Softwareentwicklung sich bisher vor allem mit solcher Datenspeicherung beschäftigt hat, ist verständlich. Wenn man etwas mit Daten der äußeren Welt tun will, dann holt man sie am besten erstmal 1:1 "ins System". Mit einer Sprache wie SQL kann man sie dann bei Bedarf in Form von Views umarrangieren; allerdings funktioniert das nur in Maßen, denn SQL kann die grundsätzliche Container-Referenz-Dichotomie nicht aufheben.

Assimilierung für eine dynamische Welt

Seit der Geburt der relationalen Datenbanken sind nun aber einige Jahrzehnte vergangen. Die Welt hat sich verändert. Die Welt und damit die Anforderungen an die Datenbanken sind dynamischer geworden. Zusammenhänge, die gestern galten, sind morgen veraltet. Die auf Statik angelegten Datenstrukturen in heutigen Datenbanken sind somit kontraproduktiv. Sie sind wie Sand im Getriebe, wie Kalk in Gelenken.

Das Problem sind zum Einen die festen Containergrenzen, in die Daten in großen Blöcken eingepfercht sind. Denn Daten in Containern lassen sich nicht mit Daten in anderen Container in neue Beziehungen bringen. Nur Container selbst können einander referenzieren. Zum anderen sind Referenzen als Teil der Daten in Containern ein Problem. Solange Referenzen in Container stecken, müssen Containerstrukturen nämlich verändert werden, um neue Beziehungen herzustellen. Solche Schemaänderungen widerstreben dann zurecht jedem Datenbankadmin, denn sie widersprechen dem grundlegenden Paradigma der statischen Strukturen aller Container-Referenz-Datenmodelle.

Um nun Daten fit für eine dynamische Welt zu machen, muss also das Datenspeicherparadigma aufgegeben werden. In einer dynamischen Welt ist nicht mehr die 1:1 Speicherung und Reproduktion von Daten der Hauptzweck von Datenbanken. Die Reproduktion von Datenstrukturen ist nicht mehr der Rede wert; sie ist selbstverständlich.

Der Hauptzweck der Datenverarbeitung ist heute vielmehr die Flexibilisierung von Daten. Sie müssen so gehalten werden, dass jederzeit neue Zusammenhänge zwischen ihnen hergestellt werden können. Daten müssen fähig werden zum Networking. Business Intelligence (BI) ist zwar schon eine Disziplin, die sich der Schöpfung von Werten aus neuen Zusammenhängen zwischen Daten widmet. Aber auch BI ist letztlich noch dem bisherigen Datenspeicherungsparadigma verhaftet.

Wahre Dynamik und maximale Flexibilität erreicht die Datenverarbeitung erst, wenn Daten nicht mehr gespeichert, sondern assimiliert werden. Denn Daten wie andere "Dinge" der realen Welt, sind immer nur so flexibel, d.h. "verformbar", wie sie aus "verschiebbaren" Einzelteilen bestehen.

image

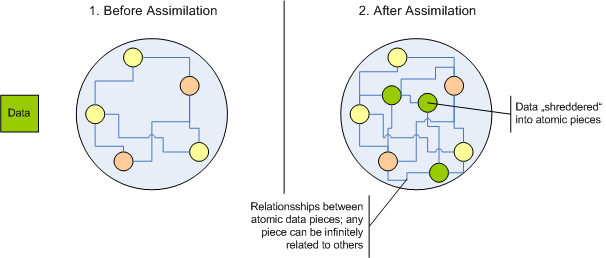
Dynamik kommt also erst in die Datenhaltung, wenn wir Daten nicht mehr als zu festen Blöcken in erhaltenswerten Containern zusammengesetzt ansehen, sondern als "Säcke" voller "Datenatome". Was diese Datenatome dann sind, ist zunächst einmal egal. Es können einzelne Bits, einzelne Zahlen, einzelne Zeichenketten oder einzelne 2 MB Blobs sein. Je feiner die Granularität dieser "Atome", desto höher jedoch die Flexibilität des "Datensacks".

Und nicht nur das! Denn diese "Datenatome" können nicht nur innerhalb eines Sacks immer wieder neu arrangiert, sondern können maximal flexibel mit "Datenatomen" anderer Säcke in Beziehung gesetzt werden. Statt Datenblöcke also einfach nur 1:1 zu speichern, müssen wir sie "shreddern". Dann erhalten wir maximal verbindbare "Datenatome". Und diese "Datenatome" assimilieren wir in eine "Wolke" schon existierender "Datenatome".

image

Assimilation besteht damit aus zwei Schritten:

  1. Datenblöcke in "Datenatome" zerlegen
  2. "Datenatome" mit schon vorhandenen vernetzen

Und der zweite Schritt kann sogar beliebig oft wiederholt werden! Per definitionem ist nicht zu befürchten, die Struktur der "Datenatome" je verändern zu müssen. Es sind ja Atome; aus Sicht einer Anwendung haben sie daher keine weitere, für zukünftige Beziehungen relevanten internen Strukturen.

Wo vorher noch Daten in Containern waren, sind nach der Assimilation die Container verschwunden und die Daten in eine "Datenwolke" (oder ist es eher ein "Datenplasma"?) aufgelöst und mit schon existierenden "Datenwolken" verschmolzen. Assimilation speichert Daten also nicht einfach, sondern löst sie in einem größeren Ganzen auf. Wie bei sonstigen Lösungen verschwindet das Aufgelöste jedoch nicht, sondern verteilt sich nur bzw. wird hier in das Vorherige integriert. Die ursprünglichen Daten sind also auch in der Gesamtheit alles Assimilierten noch enthalten - nur eben nicht klar umrissen an einem Ort wie die Datenkopien bei der üblichen Datenspeicherung. Dennoch lassen sich aus einem "Assimilat" auch wieder die ursprünglichen Daten in ihren Containern zum Zeitpunkt der Anlieferung regenieren.

Um Daten wahrhaft flexibel zu halten, müssen wir also das Operationenpaar Speichern/Laden durch das neue Paar Assimilieren/Regenerieren ersetzen. Dem bisherigen Grundanspruch der 1:1 Datenhaltung wird damit immer noch Rechnung getragen. Doch darüber hinaus eröffnet die assimilierende Datenhaltung ganz neue Möglichkeiten zur Vernetzung von Daten, zur Bildung immer neuer Zusammenhänge.

Assimilation ist die Grundlage für Synergieeffekte zwischen Daten. Durch Assimilation werden Daten so flexibel, wie sie eine immer dynamischer werdende Umwelt braucht.

Oder passend zum Jahresschluss: Speichern war 2007... Assimilation ist 2008.

Sonntag, 30. Dezember 2007

Mehr Klarheit für die Objektorientierung - Klassendiagramme entzerren

So, zum Jahresende muss ich eines noch loswerden: Klassendiagramme mag ich nicht. Oder genauer: so wie sie üblicherweise benutzt werden. Lange habe ich darüber gegrübelt, woran das liegt. Jetzt weiß ich es! Sie sind undurchsichtig, weil sie zweierlei vermischen. Sie widersprechen damit einem Grundsatz zur Bewältigung von Komplexität, dem "Separation of Concerns".

So wie UML Klassendiagramme üblicherweise benutzt werden, vermischen sie "Verwandtschaftsbeziehungen" mit "Arbeitsbeziehungen". Sie mengen Vererbungshierarchien mit Assoziationen/Aggregationen zusammen. Hier als Beispiel die übliche Darstellung des "Decorator" Entwurfsmusters:

image 
Quelle: http://www.dofactory.com/Patterns/PatternDecorator.aspx

Wer steigt da zügig durch? Erkennen Sie auf Anhieb, was Sie zu implementieren haben? Sehen Sie gleich, wer wen nutzt? Ich nicht. Ich brauche immer eine ganze Zeit, um mich darin zurechtzufinden. Und das finde ich schlicht falsch. Ein Diagramm soll für einfache Zusammenhänge - und einfach ist das "Decorator" Pattern - auch einfach zu lesen sein.

Seitdem ich nun verstanden habe, was mich an den üblichen Klassendiagrammen stört, betreibe ich auch bei ihnen strikte Zwecktrennung oder "Separation of Concerns". Hier zur Erläuterung meine Version des "Decorator" Entwurfsmusters:

1. Arbeitsbeziehungen darstellen

Am wichtigsten finde ich es, die Arbeitsbeziehungen zwischen Klassen bzw. ihren Instanzen darzustellen. Welche Objekte brauchen welche anderen? Welche Objekte enthalten (aggregieren) welche anderen? Und das alles mit den richtigen Mengenangaben (Beziehungskardinalitäten: 1:1, 1:n, n:m).

Darauf zunächst reduziert sieht das "Decorator" Pattern so schön einfach aus:

image

Alles klar? Ich hoffe! Applikationscode ruft entweder Instanzen einer "Simple Class" direkt auf oder nutzt Objekte von "Enhanced Class", hinter denen jeweils eine "Simple Class"-Objekt steht.

Da Klassen bzw. Vererbung nicht einmal zum Kern der Objektorientierung gehören, ist die Darstellung von Vererbungsbeziehungen auch nicht essenziell. In Bezug auf den "Decorator" bedeutet das: Wesentlich ist nicht, welche Klassen hier gemeinsame "Vorfahren" haben, sondern dass der "Decorator" (Enhanced Class) genauso aussieht (!) wie das zu Dekorierende (Simple Class). Das lässt sich aber schon an den gleichen Methodennamen ablesen.

2. Zusammenarbeit beschreiben

Wenn die Darstellung der Arbeitsbeziehungen bzw. des Objektgeflechts noch Fragen offen lässt, dann untermauere ich sie mit einem Sequenzdiagramm. Die Nutzung eines Decorators sieht dann zum Beispiel so aus:

image

Alles klar? Ich hoffe! Denn auch hier liegt der Fokus auf dem, was am Nutzungsort in der Applikation relevant ist. Dort hat der Code mit dem Decorator und dem Dekorierten zu tun - und nicht mit irgendwelchen möglichen Basisklassen.

3. Verwandtschaftsbeziehungen darstellen

Erst ganz zum Schluss dokumentiere ich dann die Verwandtsschaftsbeziehungen zwischen den funktional relevanten Klassen. Dann geht es um Ableitungen oder Implementationen von Interfaces. Und dann beschreibe ich womöglich sogar Alternativen. Bei "Decorator" Pattern sind das z.B. diese:

image

Alles klar? Ich hoffe! Denn eine solche Darstellung, die sich auf Vererbung konzentriert, ist doch leicht zu verstehen.

In der Literatur findet sich übrigens nur die untere Ableitungsstruktur. Aber ich denke, eine Basisklasse für alle Decorators ist nicht nötig. Wesentlich ist lediglich, dass Domänenklasse/zu Dekorierendes und Decorator eine gemeinsame Herkunft haben. Die macht sie für den Applikationscode dynamisch austauschbar.

Fazit

Nachdem ich meine Software-Detailentwürfe von "vermengenden" Klassendiagrammen auf "separierte" Klassendiagramme umgestellt habe, machen mir objektorientierte UML-Darstellungen wieder deutlich mehr Spaß. Ich kann Ihnen also nur empfehlen, grundsätzlich Verschiedenes wie Arbeitsbeziehungen und Verwandtsschaftsbeziehungen ebenfalls zu so zu trennen. Sie machen Ihre Objektemodell viel besser verständlich.

Dienstag, 25. Dezember 2007

OOP 2008: Wider die Wiederverwendbarkeit

Im OBJEKTspektrum 1/2008 hat Nicolai Josuttis einen Artikel zum Thema SOA geschrieben, der mir recht das Herz aufgehen ließ. Besonders hervorheben möchte ich hier von den vielen seiner Aussagen, denen ich beipflichte, allerdings zunächst nur diese:

"Beides zusammen führt dazu, dass sich Wiederverwendbarkeit nicht unbedingt als primärer Business-Case für SOA eignet."

Fast möchte ich darauf nur sagen: Amen.

Denn Wiederverwendbarkeit - oder Neudeutsch: Reuse - halte auch ich für stark überbewertet. Nicht nur in Bezug auf SOA, sondern allgemein in der Softwareentwicklung. Seit die Objektorientierung ihren Siegeszug angetreten hat, lautet die Botschaft "Wiederverwendung ist gut, Wiederverwendung ist ein wichtiges Ziel!".

Irgendwie klingt das ja auch ganz plausibel, nein, geradezu zwingend! Besonders für alle, die ein Auge auf´s Geld haben wollen oder müssen. Wenn etwas wiederverwendet werden kann, dann amortisieren sich die darin getätigten Investitionen umso schneller. Wer wollte das nicht?

Nun, alle die etwas mehr Weitblick haben, wollen das nicht "einfach so". Die Welt ist nicht so simpel schwarz/weiß, wie Wiederverwendungsapostel es gern hätten. Wiederverwendbarkeit steht nicht einfach unökonomische Mehrfachentwicklung gegenüber. Wiederverwendbarkeit und Wiederverwendung haben ihren Preis - und müssen daher wie jede andere Investition abgewogen werden.

Kosten der Wiederwendbarkeit und Wiederverwendung

1. Wiederverwendbares zu entwickeln, kostet deutlich mehr Aufwand, als nur für einen konkreten Zweck zu entwickeln. Es ist Zeit aufzuwenden, um die vielen möglichen Wiederverwendungsszenarien zu sammeln und zu analysieren. Es ist dabei auch mehr Personal involviert. Und die Qualität des Wiederverwendbaren muss höher sein, d.h. mehr Planungs- und Entwicklsaufwand fließt hinein, weil mehr Parteien davon abhängen. Wann sich nun aber ein solcher Mehraufwand amortisiert haben wird, ist ungewiss. Hoffnungen und Wünsche sind oft die Triebfedern, nicht glasklare Kalkulationen.

2. Wiederverwendung ist nicht kostenlos. Sobald ein Zusammenhang entsteht, in dem etwas wiederverwendet werden könnte, der zum Zeitpunkt der Herstellung der Wiederverwendbarkeit noch nicht bekannt war bzw. nicht berücksichtigt wurde, entsteht Anpassungsaufwand. Per definitionem ist die Schnittstelle von etwas Wiederverwendbarem nicht optimal für den einzelnen Wiederverwendungsfall. Wer wiederverwendet, muss sich mehr oder weniger anpassen. Und im schlimmeren Fall muss sogar das Wiederzuverwendende ebenfalls nachgeführt werden.

3. Wiederverwendbares zu finden, kostet Aufwand. Sobald Wiederverwendung nicht in überschaubarem Rahmen abläuft, man also quasi im Hinterkopf haben kann, was denn potenziell wiederverwendet werden könnte, fallen Recherchekosten an. Bei allen Entscheidungen muss explizit geprüft werden, ob "Spezialentwicklung" oder Wiederverwendung angezeigt ist. Ist der Pool des als grundsätzlich wiederverwendbar Klassifizierten groß genug, kann der Rechercheaufwand sogar womöglich den Aufwand einer Spezialentwicklung erreichen. Nicht zu vernachlässigen sind auch negative Effekte auf die Motivation der Projektmitglieder, die ihren Sinn aus dem Entwickeln ziehen und nicht aus der Suche nach Wiederverwendbarem (s. "Implementing component reuse strategy in complex products environments", Ilan Oshri et al. in CACM 12/2007).

4. Wiederverwendung erhöht die Komplexität, denn Änderungen an etwas Wiederverwendbarem haben Auswirkungen auf eine große Anzahl von Verwendern.

image

Wenn sich eine Spezialentwicklung ändert, hat das potenziell nur Auswirkung auf wenige Nutzer. Wiederverwenbares jedoch muss immer im Blick behalten, dass eine große, womöglich sogar unbekannt große Zahl Nutzer zu Anpassungsaufwand gezwungen werden könnte. Das führt über kurz oder lang zur Versteifung von Wiederverwendbarem, weil die Konsequenzen von Änderungen immer schwerer zu überschauen sind. Dem Versprechen von Änderungen, die nur noch an einem Ort vorgenommen werden müssen, steht also eine Drohung des Kompatibilitätszwangs gegenüber.

5. Wiederverwendbarkeit entwickeln, ist nicht agil. Wer etwas auf Agilität gibt, kann eigentlich kein Freund der Entwicklung von Wiederverwendbarkeit sein. Denn Wiederverwendbarkeit lässt sich nur mit einem Blick in die Glaskugel erreichen. Es muss vom aktuell Nötigen extrapoliert werden. Gefragt ist dann nicht mehr, was jetzt, hier und heute ausreichend wäre, sondern was auch noch morgige potenzielle Fälle abdecken helfen könnte. Das läuft dem Gedanken zuwider, immer nur den aktuell angemessenen Aufwand zu treiben und alle weitere Aufwände bzw. Entscheidungen auf den spätest möglichen Zeitpunkt zu vertagen - weil sich ja bis dahin wieder Anforderungen oder schlicht Erkenntnisse (über Anforderungen oder Technologien) geändert haben könnten.

Wiederverwendbarkeit ist kein Ziel, sondern ein Mittel

Und nun? Wiederverwendbarkeit ist nicht schlecht. Ich mag sie auch - wo sie sich leicht herstellen lässt oder einfach ergibt. Wiederverwendbarkeit halte ich nur einfach für kein taugliches Ziel. Kräfte sollten nicht auf Wiederverwendbarkeit ausgerichtet sein nach dem Motto "Lasst uns erst schauen, was wir wiederverwendbar machen können!" Das mag sich für Controller zwar gut anhören oder Entwicklerpersönlichkeiten entsprechen, die sich gern mit Grundsätzlichem und vor allem Infrastruktur beschäftigen. (Wer würde nicht gern seinen eigenen Persistenzframework basteln und das Thema einfürallemal lösen, statt sich mit ewig wetterwendischen Kundenwünschen herumzuplagen?)

Stattdessen sollten alle Kräfte zu jeder Zeit darauf gerichtet sein, Komplexität zu meistern - und natürlich Kundenwünsche zu erfüllen. Wiederverwendbarkeit ist aber kein Kundenwunsch. Gemeisterte Komplexität jedoch, weil sie Langlebigkeit fördert. Und wenn sich dann an einem Punkt ergibt, dass die Komplexität durch Wiederverwendung sinken würde, dann ist das wunderbar. Dann ist Wiederverwendbarkeit lediglich ein Mittel. Dann ist es Zeit, durch Refaktorisierung Wiederverwendbarkeit herzustellen - falls dem nicht zu hohe Folgekosten entgegenstehen. Aber nicht früher.

Wiederverwendbarkeit und SOA?

Wiederverwendbarkeit und SOA haben deshalb soviel miteinander zu tun wie Wiederverwendbarkeit und Objektorientierung oder Wiederverwendbarkeit und Komponentenorientierung. SOA-Dienste können Einheiten der Wiederverwendung sein wie Objekte oder Komponenten. Mehr nicht. Es gibt keinen SOA-Grundsatz, der da lautet "Services should be as reusable as possible" oder dergleichen. SOA-Services können wiederverwendbar sein - aber ob das angemessen ist, steht auf einem ganz anderen Blatt.

SOA wie Komponentenorientierung - die Objektorientierung lasse ich einmal bewusst außen vor - haben vor allem ein Ziel: die Beherrschung von Komplexität. Große Systeme sollen verstehbar und evolvierbar sein und bleiben. Darum geht es. Und deshalb halte ich eine "System Oriented Attitude" für den wichtigsten Ausgangspunkt aller Softwareentwicklung.


PS: In der Entwicklungsgeschichte eines Systems kann es übrigens zu gegenläufigen Bewegungen kommen: Ähnliche Funktionalität kann zu Wiederverwendbarer zusammengefasst werden (Integration) - Wiederverwendbares kann aber ebenso wieder aufgespalten werden, wenn es versucht, zuvielen Herren zu dienen (Desintegration). Auch diese Möglichkeit gilt es im Blick zu behalten. Wahrhafte Agilität versteift sich nicht auf einen Zustand.

OOP 2008: Innovation und Wettbewerb

Michael Stal bricht in Reaktion auf mein Posting nochmal eine Lanze für Wettbewerb als Innovationsmotor. Was nun? Wie so oft, wenn These und Antithese sich gegenüberstehen, lohnt die Suche nach einer Synthese bzw. nach einem solch Gegensatz zugrundeliegenden Missverständnis. So auch in unserem Fall.

Ich denke, unser beider Positionen sind komplementär. Innovation braucht Mut, Einfühlungsvermögen, Sensibilität und (!) Wettbewerb! Na, wie ist das, Michael? ;-)

In meinem vorherigen Posting zu dem Thema hatte ich mich gegen Michaels Aussage gewandt, Wettbewerb sei die entscheidende Voraussetzung für Innovationen. Das finde ich nachwievor falsch. Innovation entsteht nicht aus dem Wettbewerb von Innovierern (einzelnen oder kollektiven). Denn Innovation hat nichts mit Wettbewerb zu tun, sondern mit Linderung von Leiden. Leiden lindert aber niemand, weil er darin besser sein will als jemand anderes, sondern schlicht, weil er sich davon einen direkten (Reduktion eigenen Leidens) oder indirekten Vorteil (Entlohnung für die Reduktion fremden Leidens) verspricht.

Insofern bleibe ich dabei, dass zunächst einmal für Innovationen all das wichtig ist, was Erkennen von Leiden und Heilung befördert. Wettbewerb gehört nicht dazu.

Allerdings: Wenn denn ersteinmal eine Innovation geboren ist, dann kann Wettbewerb einen positiven Effekt auf sie haben. Wettbewerb kann helfen, Innovationen besser genießbar zu machen, sie zuzuschleifen. Und Wettbewerb hilft nach unserem marktwirtschaftlichen Credo, den Preis für Innovationen zu senken.

Zeugung und Gestation einer Innovation profitieren nicht von Wettbewerb. Beim Wachstum einer Innovation jedoch, bei ihrer Reifung, da hilft Wettbewerb, weil Wettbewerb motiviert, sich nicht auf der initialen Innovation auszuruhen. So gut sie sein mag, sie ist zunächst noch roh. Wettbewerb macht dann sensibel für den Dialog zwischen Leidenden und konkurrierenden Innovierern. Denn kann helfen,die Innovation passgenau zu machen.

Wettbewerb hat also durchaus einen Platz bei Innovationen. Dennoch halte ich es für Bedenkenswert, wieviel Wettbewerb einer Innovation zuträglich ist. Und ich glaube weiterhin daran, dass Wettbewerb oft zu groß im Vergleich zu Kooperation geschrieben wird. Denn Wettbewerb hat mit Mauern zu tun. Wettbewerber sind ja gerade Wettbewerber, weil sie sich nicht in die Karten schauen lassen wollen. Das aber verhindert den Austausch von Erfahrungen, das führt zu genauso sinnlosen wie teuren Parallelentwicklungen, das steht Konvergenz (oder gar Standardisierung) entgegen.

Aber das rührt nun an ein anderes Thema - Evolution -, zu dem Michael allerdings auch eine Bemerkung gemacht hatte. Er sprach von Mutation und Selektion. Davon aber ein andermal. Denn auch die Bedeutung von Mutationen halte ich für übertrieben im Vergleich zur Symbiose. Aber davon ein andermal...

Montag, 24. Dezember 2007

OOP 2008: Innovation braucht Einfühlungsvermögen und Sensibilität

Mich hat der "philosophische" Beitrag von Michael Stal im OOP-Blog gefreut. Das ist die Art Nachdenken, die mir gefällt: raus aus den technologischen Niederungen, Abstand vom Hype nehmen und einmal über Grundsätzliches nachdenken. Wie ist das also mit der Innovation in der Softwarebranche? Zugegeben, eine sehr allgemeine Frage, aber in jedem Fall bedenkenswert.

Michael konstatiert: "Es bedarf des Wettbewerbs der Ideen (Evolutionen) um Anreize für Innovation zu schaffen [...]". Ist das aber wirklich so? Braucht Innovation einen Wettbewerb? Nein, das halte ich für zwar verständliches, aber überkommenes Denken nach kapitalistischer/westlicher Väter Sitte. Dass Wettbewerb die stärkste Fortschrittskraft ist, ist längst schon als Illusion entlarvt. Kooperation statt Wettbewerb heißt die Zauberformel.

Woher kommen dann aber Innovationen, wenn sie nicht durch Wettbewerb "angestachelt werden"? Zunächst scheint es nützlich, zur Beantwortung dieser Frage zu überlegen, was Innovation eigentlich ist. Und da sage ich mal, Innovation steht dem Informationsbegriff nach Gregory Bateson insofern nahe, als dass sie einfach ein Unterschied ist, der einen Unterschied macht:

  1. Unterschied: Innovation weicht vom Existierenden ab.
  2. Unterschied: Diese Abweichung führt dazu, dass wir zunächst einmal ganz allgemein anders arbeiten als bisher. Im Speziellen nehmen wir diese Andersartigkeit jedoch positiv wahr.

Mit dieser Definition von Innovation kann die Frage nach ihren Quellen nun differenzierter gestellt werden:

  1. Was sind Bedingungen, die zur Produktion einer Abweichung vom Existierenden führen?
  2. Welche Abweichungen nehmen wir als positiv wahr?

Zu Frage 1: Schierer Wettbewerb kann natürlich der Antrieb sein, Unterschiede der ersten Art zu produzieren. In Wirklichkeit geht es dem Produzenten dabei jedoch nicht um diesen Unterschied in der Sache, sondern um einen Unterschied zum Wettbewerb bzw. seiner bisherigen wirtschaftlichen Position. Die Innovation ist dann nur Mittel zum Zweck. Das halte ich für die schlechteste aller Motivationen für Innovationen.

Viel wirksamer scheint mir hingegen die Motivation aus Leiden heraus. Wer am Existierenden leidet, sucht nach Wegen, dieses Leiden zu beenden. Oder volkstümlicher: Not macht erfinderisch. Allererster Innovationsmotor ist für mich daher Sensibilität! Sensibilität für die eigenen Leiden und Sensibilität für die Leiden anderer, d.h. der heutigen oder potenziellen Kundschaft.

Ob auch noch andere am Markt sensibel sind, ist dabei unerheblich. Ich würde sogar sagen, dass ein "Wettbewerb der Sensiblen" zunächst hinderlich für Innovation ist, da er die ursprüngliche Leidenssensibilität ankränkelt. Statt alle Kräfte auf Heilung des Leidens auszurichten, also einen in der Sache positiven Unterschied zu produzieren, motiviert Wettbewerb, Kräfte in einen Unterschied zu den Wettbewerbern zu investieren. Das schwächt die Innovation.

Zu merken ist diese "unechte" Motivation bei allen etablierten Produkten von Microsoft Office bis SAP. Wenn ihre neuen Versionen mit Veränderungen zur bisherigen oder Konkurrenzprodukten aufwarten, dann sind diese Veränderungen vor allem durch den wirtschaftlichen Zwang, d.h. den Wettbewerb motiviert. Das ist Innovation um der Innovation willen, weil sich sonst die Software nicht mehr im Rahmen des vorherrschenden Geschäftsmodells verkaufen lässt. Nüchtern betrachtet würde das Urteil wohl lauten: Viele etablierte Produkte sind am Ende. Sie sind für 80-90% der Kundschaft gut genug und müssen nicht weiterentwickelt werden. Echte Innovationen sind nicht mehr in ihnen oder mit ihnen möglich.

Zu Frage 2: Welche Unterschiede werden als positiv empfunden? Hier ist Einfühlungsvermögen gefragt und Domänenkenntnis. Wer Unterschiede der ersten Art produzieren will, die Unterschiede der zweiten Art machen, muss nicht nur sensibel sein, sondern sich in die Position seiner Kunden versetzen können. Was sind deren Wünsche, Sorgen, Nöte, Ziele? Beispiel: Möchte die Kundschaft einen schnelleren Rechner, weil die Datenbankzugriffe immer so langsam sind? Oder möchte die Kundschaft eine schnellere Datenbank? Oder möchte die Kundschaft einen leichter zu bedienenden Datenbank-API, der vor imperformanter Verwendung schützt? Oder möchte die Kundschaft überhaupt eine ganz andere Programmierplattform mit Persistenz, die noch umfassender vor imperformanter Fehlbenutzung schützt? Oder wäre die beste Lösung, auf Persistenz ganz zu verzichten und stattdessen alle Daten in-memory zu verarbeiten?

Wer nicht versteht, wo der Schuh wirklich drückt, der erzeugt womöglich Unterschiede an falscher Stelle. Der betreibt Symptomkur, statt zu heilen. Das bringt dann zwar auch eine gewisse Linderung, aber nicht wirklich dauerhafte Abhilfe.

Innovationen können aus meiner Sicht also nur da entstehen, wo Einfühlungsvermögen und Sensibilität zusammenkommen. Einfühlungsvermögen öffnet, Sensibilität registriert. Wettbewerb ist beidem jedoch abträglich, denn Wettbewerb hat mit Adrenalin zu tun. Und Adrenalin führt zu Regression, zu Tunnelblick. Wer unter Adrenalin steht, der ist aus evolutionsgeschichtlich guten Gründen gefühlstaub.

Soviel zu Michael Stals (Syn)These, dass Innovation Wettbewerb brauche. Ich verstehe, was er damit meint. Und im gegebenen Wirtschaftssystem bzw. bei den aktuellen Geschäftsmodellen für Software ist Wettbewerb auch unumgänglich. Auch im Sinne einer freundschaftlichen Herausforderung ist darüber hinaus nichts gegen ihn zu sagen. Dass Wettbewerb jedoch essenziell, geradezu der Katalysator für größte Innovationen sein soll... das kann ich nicht glauben. Da scheinen mir Einfühlungsvermögen und Sensibilität als Fundament viel wichtiger. Ihnen muss sich dann allerdings auch noch Mut zugesellen. Sonst bleiben Innovationen in der Schublade.

Mut zum Riskio, Mut zur Lücke, zum Fehler, Mut zum Nonkonformismus, Mut zum Imperfekten, zum Vorläufigen... Vielleicht ist der Mut sogar noch wichtiger. Ja, sogar ganz gewiss. Erst kommt der Mut, dann die Zuversicht, dann Einfühlungsvermögen und Sensibilität. Schließlich Beredtheit, also Wille und Fähigkeit, die Frohbotschaft der Innovation zu verkünden. Von der Sachkompetenz und fachlichen Qualifikation ganz zu schweigen. Den Wettbewerb hingegen, den braucht die Innovation nicht so recht.