Follow my new blog

Freitag, 23. März 2007

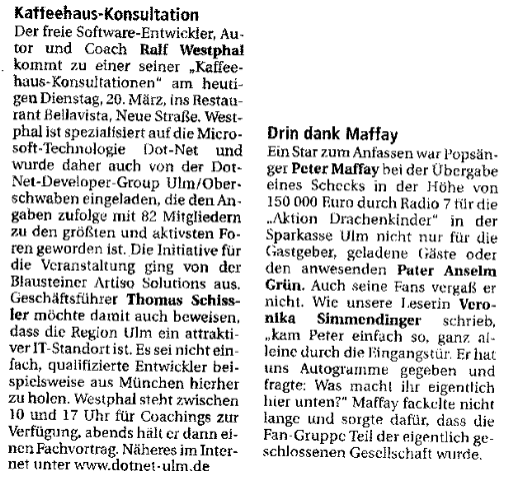
Maffay neben Westphal - Kaffeehauskonsultation in Ulm

So kann es kommen: Ahnungslos fahre ich nach Ulm zur Kaffeehauskonsultation - und finde neben mir Peter Maffay. Aber nur in der Zeitung :-) Oder anders: Allerdings in der Zeitung, denn bisher hatte ich nicht geahnt, dass kostenloses .NET Technologiecoaching für die Lokalpresse von Interesse wäre. So stand es jedoch am 20.3. in der Neuulmer Zeitung:

Verständlich wurde diese Nähe zu Peter Maffay dann jedoch, als Thomas Schissler erklärte, er habe anlässlich meines abendlichen Vortrags vor der UG Ulm eine Presseerklärung an die Zeitung geschickt. Und ich dachte schon, die Lokalpresse verfolgt mein Blog... ;-)

Ob der Artikel allerdings viel gebracht hat, weiß ich nicht. Die Kaffeehauskonsultation war auch ohne ihn 2 Wochen vor dem Termin schon "ausverkauft". Von 10h bis 17h gaben sich Entwickler die Klinke in die Hand und ich hatte Mühe, zwischendurch einen Happen zu essen. Aber passt schon. Hat wieder viel Spaß gemacht.


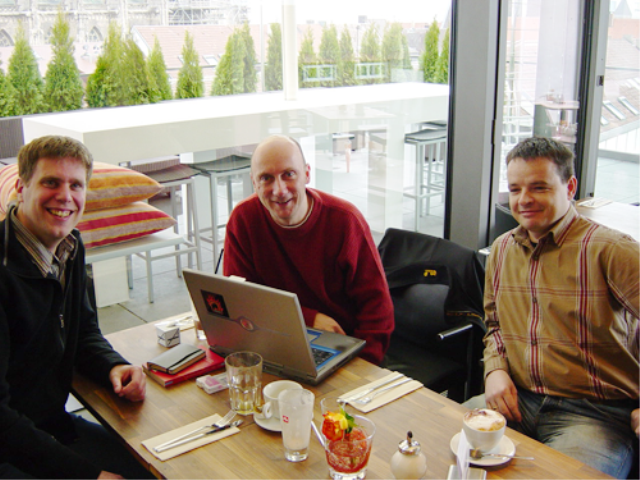
Links Thomas Schissler, rechts Andreas Gümbel, der sich mit mir darüber unterhalten wollte, wie er ein single-sign-on für mehrere Web-Applikation realisieren kann.

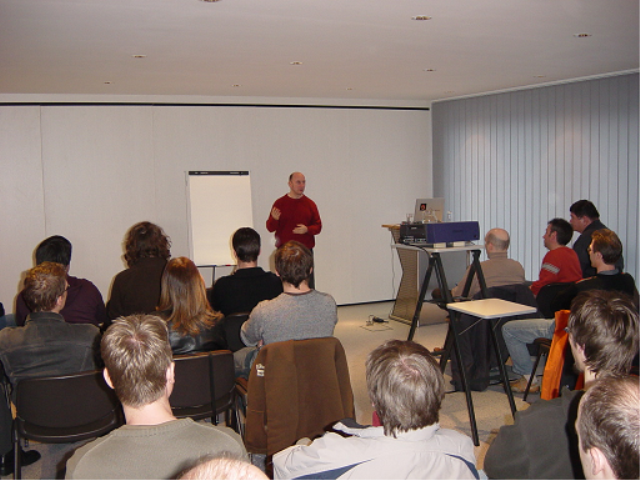
Auch der Vortrag am Abend in den Räumen von artiso fand vor einem vollen Haus statt.

Knapp 40 Entwickler waren gekommen, um sich einen Eindruck davon zu verschaffen, wie der Weg zur mehr Produktivität, besserer Testbarkeit, einfacherer Wartbarkeit und größerer Verständlichkeit ihrer Applikationen durch echte Komponentenorientierung aussehen könnte. Nach etwas mehr als 2,5 Stunden wussten sie es dann - hoffentlich :-) Denn solange habe ich doch für meinen Vortrag am Flipchart mit anschließender Demo in VS2005 gebraucht.

Die Kombination Kaffeehauskonsultation + UG-Vortrag - danke an INETA für´s Sponsoring - hat mir gut gefallen. Mache ich gern wieder.

Danke an Thomas Schissler für seine Initiatve! Das ist Nutzung der Angebote von Microsoft at its best.

Mittwoch, 21. März 2007

Vom Guten im Schlechten - TurboDb besser dank "Passionsspiele"

In der dotnetpro 4/07 hatte ich unter dem Titel "Passionsspiele" - passend zum Ostermonat ;-) - von meinem Leidensweg bei der Portierung einer .NET 2.0 Anwendung nach Mono berichtet. dnpMelodie, ein (noch und zugegebenermaßen rudimentärer) Windows Media Player/iTunes Clone, wollte ich mal eben so auf Linux umstellen, weil das aufgrund der komponentenorientierten Architektur einfach schien. Leider ging das aber daneben, weil Mono derzeit noch zu wenig kompatibel zu .NET 2.0 ist und... ja, und auch die Datenbank, von der ich dachte, das sie hüben wie drüben laufen würde, eben das nicht tat.

Ich hatte mich für die Neuentwicklung der Datenzugriffskomponente, die zunächst auf die Jet Engine ausgelegt war, für TurboDb von DataWeb entschieden. TurboDb Managed ist eine rein in Managed Code geschriebene Datenbank und sah für mich daher so aus, als sei sie der ideale Kandidat. Wie sich dann allerdings herausstellte, war TurboDb Managed nicht 100% kompatibel zu Mono. Leider hatte ich das aber erst gemerkt, als ich die Datenzugriffskomponente schon neu entwickelt hatte. War dann schade, aber machte auch nicht soviel. Ich hab es dann mit db4o nochmal probiert und die DB-Engine lief dann auch unter Mono - nur meine Anwendung trotzdem noch nicht.

Aber egal. Denn um die Inkompatibilität von TurboDb mit Mono geht es mir hier nicht. Nerviger waren vorher nämlich einige Stolpersteine während des Umbaus auf TurboDb unter .NET. Da funktionierte die SQL ORDER-BY-Klausel nicht wie mit der Jet Engine und ein Feldname war plötzlich ein reserviertes Wort und die Escape-Zeichen für solche Fällen waren schlecht dokumentiert. Davon habe ich dem Artikel im Sinne eines Entwicklungsprotokolls dann auch berichtet.

Und nun hat mich der Hersteller von TurboDb kontaktiert, nochmal genauer erfragt, was mein Problem war... und hat die Probleme behoben. Hier ein Auszug aus der Email von DataWeb:

Hallo Herr Westphal,

vielen Dank für Ihre Hinweise.

Bei der Sortierung haben Sie einen Bug entdeckt. Er betrifft Strings der Länge 1 in ANSI-String-Feldern (also nicht Unicode) der Länge 256 und darüber. Die Ursache liegt im Kompatibilitätscode zu alten Versionen, wo diese Felder nur bis 255 Zeichen lang sein durften. Der Fehler wird noch diese Woche behoben.

TurboDB Managed unterstützt Bezeichner in doppelten Anführungszeichen, wie es der SQL-Standard vorsieht. Das ist auch dokumentiert (im Kapitel über Spaltennamen) wenn auch zugegebenermaßen etwas unscheinbar. Wir haben aber auf Ihre Bemerkungen hin auch die eckigen Klammern ergänzt, wie sie in der MS-Welt üblich sind. Außerdem gibt es jetzt ein AddWithValue für die Parameterkollektion.

...

Das nenne ich prompte Reaktion! Toll! Danke, Herr Holzinger!

Und was lernen wir daraus? Ein bisschen maulen in der Öffentlichkeit hilft. Die Hauptaufgabe von technischen Artikeln ist natürlich zu zeigen, was geht. Aber wenn etwas nicht geht, sollte das nicht einfach stillschweigend mit einem Workaround verborgen werden, sondern durchaus auch in einem Artikel zu Kenntnis der Leser wie auch des Herstellers gebracht werden. Und Hersteller - insbesondere kleinere wie DataWeb - können Pluspunkte sammeln, wenn sie solche Hinweise ernst nehmen und Reaktion zeigen. Sie können damit einen Vorteil gegenüber den Platzhirschen ausspielen: ihre Agilität. Es heißt ja schon lange nicht mehr "Der Große schlägt den Kleinen", sondern auch "Der Schnelle/Flexible den Langsamen/Starren".

Also: Wer eine embedded Datenbank geschrieben in Managed Code sucht, der sollte einen Blick auf TurboDb Managed werfen. Man ist dort kundenorientiert. Das finde ich geiler als Geiz :-)

Montag, 19. März 2007

Das Intuitive Datenmodell IV - Werte als Schnittpunkte

Das Intuitive Datenmodell (IDM) kennt nur ineinander geschachtelte Werte. Eine Intuitive Datenbank (IDB) ist damit ein großer Raum, in dem solche Werte gespeichert werden. Eine beschränkende Vorstrukturierung in Tabellen und Tabellenzeilen ist ihr fremd. Sie kennt nur ein Konzept: den schachtelbaren Wert.

Die Kommunikation mit einer IDB geschieht jedoch in "Happen", die ich einmal Dokument nenne. Jedes Dokument ist eine Ansammlung von Werten, die allerdings im Speichervorgang in das schon vorhandene Wertegeflecht eingewoben werden. Eine IDB nimmt ein Dokument also nicht wie eine RDB einfach in Form einer Kopie auf! In einer IDB existieren keine Daten mehr in Kopie. Eine IDB enthält Werte der "äußeren Welt" und insofern auch Kopien. Aber jeden Wert aus der äußeren Welt, der in einem oder vielen Dokumenten steckte, die einer IDB "dargeboten" wurden, enthält die IDB nur einmal.

Das Relationale Datenmodell (RDM) kennt natürlich im Grunde auch Datengeflechte. Sie werden durch die Beziehungen zwischen Datensätzen hergestellt. Dennoch hat für mich das Daten- bzw. Wertegeflecht des IDM noch eine andere Qualität. Im IDM können nämlich Daten nicht anders, als sich zu verflechten. Es passiert ganz automatisch. Im RDM müssen Sie das Geflecht sehr bewusst weben, indem Sie Beziehungen über Fremdschlüssel aufbauen. Im IDM hingegen "passieren" Beziehungen ganz von allein immer und notwendig überall dort, wo Dokumente dieselben Werte enthalten.

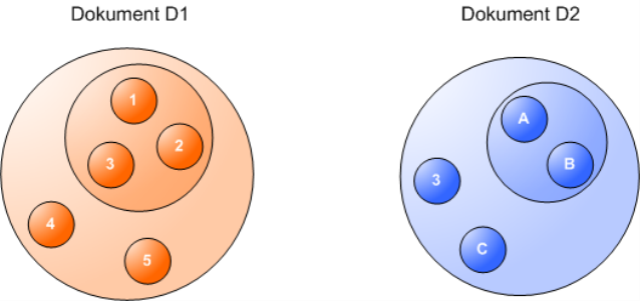
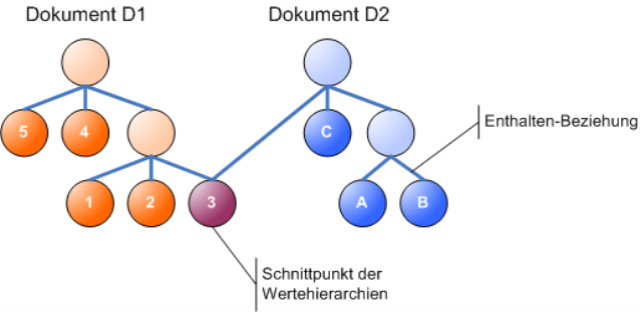
Da das IDM alle Werte nur einmal enthält - und das auf allen Strukturebenen von Dokumenten -, teilen sich Dokumente gleiche Werte automatisch. Gleiche Werte sind quasi die Schnittpunkte von Dokumenten. Hier zwei Dokumente, in denen derselbe Wert in unterschiedlicher Schachtelungstiefe vorkommt:

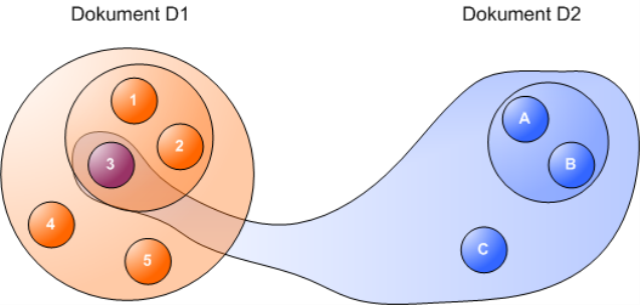
Aus Sicht des IDM schneiden sich diese Dokumente in dem Wert, der in beiden vorkommt. Sie überlappen in ihm, er gehört zu beiden Dokumenten gleichzeitig.

Einfacher ist dieses Schneiden von Dokumenten allerdings mit einem Baum darstellbar. Er führt zwar wieder Verbindungen zwischen Werten ein, aber die sollen nur Zugehörigkeit beschreiben. Sie definieren eine Enthalten-Beziehung wie die Zusammenfassung von Werten in den vorstehenden Bildern. Verwechseln Sie sie bitte nicht mit Referenzen im Objektorientierten Datenmodell  (ODM) oder Fremdschlüsseln des RDM.

Dokumente können eine beliebige Anzahl solcher Schnittpunkte haben. Enthält ein Dokument mehrfach denselben Wert, so schneidet es sich sogar mit sich selbst.

Für das Verständnis des IDM ist es zentral, den Effekt dieser Dokumentenschnitte zu verstehen. Sie führen dazu, dass sich in einer IDB nicht einfach eine Anzahl nebeneinanderliegender Dokumente anhäuft, sondern alle Dokumente zusammen ein großes Ganzes ergeben. Alle Dokumente sind miteinander verwoben, ohne dass dafür etwas Spezielles getan werden müsste.

Auch sehr Verschiedenes berührt sich dort, wo es Gleiches enthält. Das ist wie im richtigen Leben: Die vorstehende Grafik enthält einen Baum und lässt damit diesen Text mit einem Wald in Verbindung treten. So unterschiedliche Zusammenhänge wie Software und Natur berühren sich im Begriff Baum. Diese Berührung haben Sie und ich nicht geplant, sie entsteht einfach in Ihrem und meinem Kopf durch Verwendung desselben Begriffs hier wie dort.

Im richtigen Leben begrüßen wir solche spontanen Überschneidungen von ansonsten ganz Verschiedenem. Wir versuchen sogar, sie mit Kreativitätstechniken zu befördern. Wem solche Assoziationen leicht fallen, wird gewöhnlich beneidet. Sie sind ein Merkmal von Intuition, wenn sie denn irgendwann bewusst werden. Wannimmer wir ausrufen, "Ach, das erinnert mich an..." oder "Das ist genauso wie bei...", dann sprechen wir über einen solchen Schnittpunkt von Kontexten. Natürlich kann das umso häufiger passieren, je mehr "Weltwissen" wir haben, je aufmerksamer wir beobachten. Jeder Schnittpunkt ist dann ein Brückschlag und lässt uns etwas Neues erkennen.

Analogien sind in diesem Sinne bewusste Brückenschläge, um Zusammenhänge zwischen ansonsten Unverbundenem herzustellen, um Eigenschaften eines Kontexts mit denen eines anderen in Beziehung zu setzen.

Genauso ist es im IDM: Indem Dokumente sich automatisch in jedem übereinstimmenden Wert schneiden, werden immer wieder Verbindungen zwischen ansonsten Unverbundenem hergestellt. Es können und sollen sich Assoziationen ergeben, die quasi unplanbar sind. Dieser Effekt ist natürlich umso größer, je mehr Dokumente in eine IDB aufgenommen werden und je vielfältiger sie sind.

Anders als beim ODM/RDM ist für die Verbindung der Dokumente jedoch viel weniger Planungsaufwand zu treiben. Niemand muss sich hinsetzen und Verbindungen im Sinne von Container-Referenzen planen. Sie ergeben sich vielmehr einfach so im Verlauf der Aufnahme von immer mehr Dokumenten in einen IDM-Werteraum. (Die Diskussion, wie man die Assoziation von Dokumenten durch etwas Planung befördern kann, möchte ich auf einen zukünftigen Artikel vertagen.)

 
Bild anklicken zur Vergrößerung

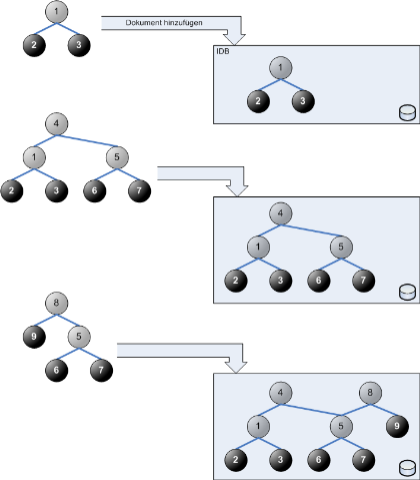
Das Endresultat der Aufnahme von immer mehr Dokumenten in eine IDB ist ein großes Dokument, dem man nicht mehr ansehen kann, in welcher Reihenfolge seine Teile hinzugefügt wurden. Auch die ursprüngliche Granularität der darin eingegangenen Dokumente ist nicht mehr erkennbar. Aufgenommene Dokumente verlieren sozusagen ihre Identität. Sie werden einfach Teil eines größeren Ganzen; sie werden assimiliert wie Menschen von den Borg bei Star Trek.

Diese Assimilation ist kommutativ und idempotent:

  • Sie kann in beliebiger Reihenfolge stattfinden und führt immer zum selben Ergebnis. Dokument A + Dokument B führt genauso zu "Gesamtdokument" C wie B + A.
  • Dasselbe Dokument kann beliebig oft assimiliert werden: A + B = C, aber auch A + B+ B = C oder A + A + B = C.

Dienstag, 13. März 2007

Software als System X - Von der Struktur zur Kooperation

Die logische und die physische  Swolarchie beschreiben Software noch nicht als System. Sie definieren lediglich die Bestandteile aus zwei unterschiedlichen Blickwinkeln. Sie beschreiben, welche Bestandteile aus welchen anderen bestehen. Durch Aufspannen einer Modulhierarchie können Sie sich schrittweise der Problemlösung nähern. Sie verfeinern sie durch neue Hierarchieebenen, wo sie sie für noch zu kompliziert/undurchsichtig halten. Dabei geht es aber nur um grundsätzliche Verantwortlichkeiten im Sinne der Produktion von Anwendernutzen und noch nicht darum, wie der am Ende konkret entsteht. Für ein gegebenes Modul ist die Leitfrage: "Aus welchen Rollen/Submodulen könnte dieses Modul bestehen, die zusammen seine Leistung erbringen?"

Die Modularisierung einer Software dient nur der Ermittlung derjenigen Rollen, die zur Lösung des Gesamtproblems "irgendwie" nötig sind. Ziel ist eine Menge von Modulen, die als Komponenten implementiert werden können.

 
Click image to enlarge

Am Ende der Modularisierung wissen Sie also, was grundsätzlich zu tun ist. Es ist dann klar, welche Bauteile herzustellen sind, aus denen die Software dann zusammengesetzt werden kann. Wie das dann geschieht, beschreibt die physische Swolarchie. Die Modulhierarchie ist sozusagen der Herstellungsplan, die physische Swolarchie der Bauplan für Software.

Modellierung ist kein Selbstzweck. Sie dient vielmehr der Beantwortung von Fragen:

  1. Wer tut am Ende was?
  2. Wo tut wer etwas?
  3. Wie tut wer etwas?

Warum und Wofür sind der Ausgangspunkt und durch die Anforderungen an die zu entwickelnde Softwarelösung gegeben.

Die Modulhierarchie ist die Antwort auf die erste Frage. Ihr Ergebnis ist eine Liste von Rollen oder Verantwortlichen, den Hybriden, die am Ende die "Fabrik Software" konstituieren. Die Modularisierung ermittelt diese Verantwortlichen aber nur, setzt sie quasi nur ungeordnet in einen Raum. Das kann auf jeder Ebene des Herstellungsplans geschehen (s. die Schnitte im obigen Bild).

Der Bauplan beantwortet die zweite Frage. Er legt fest, wo die Hybriden im späteren Softwaresystem zum Einsatz kommen, zu welchen Superkomponenten oder Prozessen sie zusammengesetzt werden müssen, um ein im Sinne der Anforderungen funktionsfähiges Ganzes zu ergeben.

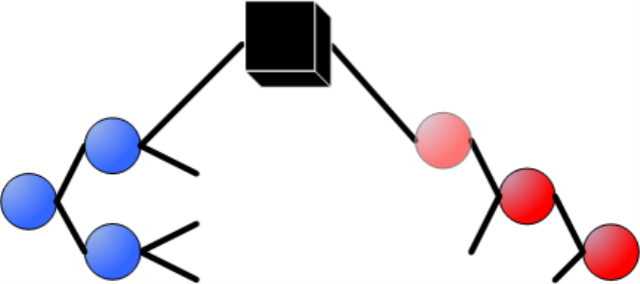
Und wer beantwortet die dritte Frage? Es ist ein weiterer Plan nötig, der Kooperationsplan. Ein Kooperationplan beschreibt für einen Schnitt durch eine Ebene von logischer oder physischer Swolarchie die Verbindungen zwischen den Swolons. Er definiert, wie die Swolons miteinander kooperieren/kommunizieren, um zusammen Anwendernutzen hertzstellen.


Click image to enlarge

Die Beziehungen zwischen Swolons in einem Schnitt müssen dabei natürlich grundsätzlich denen in anderen entsprechen, die denselben Systemausschnitt beschreiben. Bei den Kooperationsplänen für Schnitt 1 und Schnitt 2 im vorstehenden Bild ist das der Fall. Die gestrichelten Pfeile zeigen das Mapping von logischen Swolons auf physische inkl. ihrer Verbindungen. Die Modellierung muss hier also ein Auge auf die Konsistenz der unterschiedlichen Pläne haben.

In UML werden Kooperationspläne als Kollaborationsdiagramme dargestellt. Ich möchte mich in dieser Serie jedoch nicht zu sehr an UML binden, um den allgemeinen Begriff der Swolons nicht mit Bedeutungen aufzuladen, die ihm angesichts seiner Jugend schaden könnten. UML wurde vor allem aus C++ und Java geboren und hat seine Wurzeln bei allem Willen zur Allgemeingültigkeit also in der Objektorientierung. Mein Ziel ist jedoch, über die Objektorientierung hinaus zu gehen, sozusagen auf sie zu steigen, um auf ein höheres Level bei der Softwareentwicklung zu kommen. Komplexe Software zu beschreiben darf nicht (zu früh) von Konzepten der Objektorientierung behindert werden.

Paket-, Komponenten-, Klassen- und Kollaborationsdiagramme haben alle ihren Wert. Wenn Sie sie zur Darstellungen von Swolarchien benutzen wollen, dann tun Sie das gern. "Software als System" steht dem nicht im Wege. Ob die Diagramme dann allerdings so hübsch aussehen, wie die Grafiken in dieser Postingreihe... das weiß ich nicht ;-)

Montag, 12. März 2007

Software als System IX - Komponenten als Nahtstelle zwischen logischer und physischer Struktur

Bei der Modellierung von Software finde ich es ganz wichtig, immer die Verbindung von Modell zur Realität im Blick zu behalten. Denn dass reine Modelle nach Beginn der Implementierung kaum das Papier wert sind, auf dem sie ausgedruckt worden, ist ja schon lange bekannt.

Wie kann nun aber ohne MDA-"Gedöns" ;-) eine Nähe von Modell zu Code hergestellt und auch erhalten werden? Ich meine, die Voraussetzung dafür ist eine Verzahnung von logischer und physicher Swolarchie. Das geschieht am besten auf der Blattebene der Modulhierarchie. Module, die Blätter sind, sollten einem physischen Swolon gleichgesetzt werden.

Darüber hinaus sollte dieses physische Swolon jedoch relativ stabil sein, so dass Typen eigentlich ausgeschlossen sind. Für mich findet daher der Übergang von logischer zu phyischer Swolarchie auf Komponentenebene statt. Aus welchen Komponenten eine Software besteht, unterliegt viel seltener Änderungen als die Menge ihrer Klassen. Eine logische Planung gerät deshalb weniger schnell aus dem Tritt mit der Coderealität, wenn sie nicht versucht, zu detailliert zu sein.

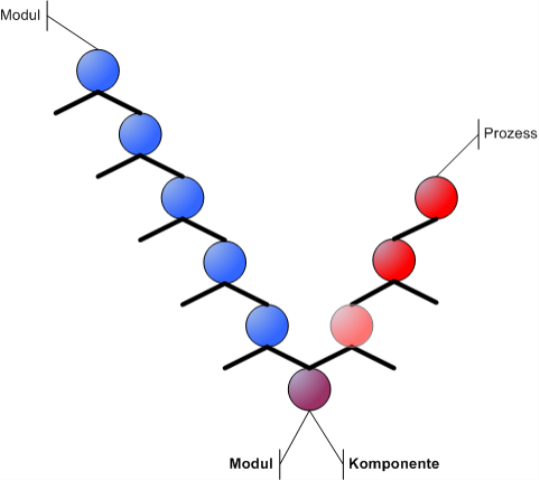
Das Blatt-Modul der Modulhierarchie ist also hybrid. Es ist sowohl ein Modul wie auch eine Komponente. Unter ihm setzt sich die Hierarchie jedoch nur mit physischen Swolons fort. Über ihm kann die Modulhierarchie beliebig viele Ebenen haben; aber auf der physischen Seite reicht sie natürlich nur bis zum Prozess hoch.

Hybride können selbstverständlich auf der logischen Seite wie jedes andere Modul Teil mehrere Module sein. Und sie können auf der physischen Seite Teil mehrerer Superkomponenten, AppDomains oder Prozesse sein. Die Modellierung mit Swolons unterstützt also den Wiederverwendungsgedanken.

Aus welchen/wievielen Assemblies, Typen und Methoden ein Hybride besteht, ist für die Modellierung transparent. Sie sollte, so meine ich, bei den Hybriden enden. Auch diese Entscheidung ist ein Mittel, um den Trend zur Entfernung von Modell und Coderealität zu unterdrücken. Hybriden sind Black Boxes für die logische Modellierung und auch für die physische Implementierung. Damit sind sie die entscheidenden Swolons, mit denen Wiederverwendung erreicht werden kann.

Die Entscheidung über die Details eines Hybriden, über seine internet physische Struktur, sollte nicht bei der Modellierung liegen, um sich zum einen nicht in Details zu verzetteln, zum anderen aber auch, um Verantwortung und Flexibilität dorthin zu delegieren, wo die Entscheidungen aufgrund des Tagesgeschäfts gemacht werden: zu den Entwicklern. Komponentenentwickler werden so zu autonomen organisatorischen Einheiten aufgewertet. Aufgabe der Modellierung ist es, ihnen einen Rahmen zu stecken, innerhalb dessen sie ziemlich freie Entscheidungen treffen können, ohne Gefahr zu laufen, andere Teile des Systems in Mitleidenschaft zu ziehen.

Software als System verleugnet die Objektorientierung also nicht, sondern verschiebt nur den Fokus auf Komponenten, wenn es um die Planung der Implementierung geht. Objekte/Typen spielen innerhalb von Komponenten weiterhin eine große Rolle. Und der Funktionalität-Daten-Dualismus ist eine zentrale Eigenschaft aller Swolons. Zur Modellierung von Software eignen sich Objekte/Typen jedoch nicht. Sie sind einerseits als physische Swolons zu klein, die Modellierung wäre zu feingranular. Andererseits sind sie auch zu konkret, um nützlich für eine logische Modellierung zu sein, denn Typen lassen sich nicht flexibel genug schachteln.

Sind logisches und physisches Modell nur über Blatt-Module bzw. Komponenten verzahnt? Zunächst einmal ja. Aber es steht natürlich einer Korrespondenz von darüber liegenden Modulen mit physischen Swolons nichts im Wege. Ein Modul einem Prozess entsprechen zu lassen, ist natürlich erlaubt. Als mehr als eine lose Korrespondenz würde ich solch eine Beziehung allerdings nicht bezeichnen. Ein direktes Mapping von logischem auf physisches Swolon sehe ich nur bei Blatt-Modulen auf Komponenten.

Sonntag, 11. März 2007

Software als System VIII - Physische Strukturierung

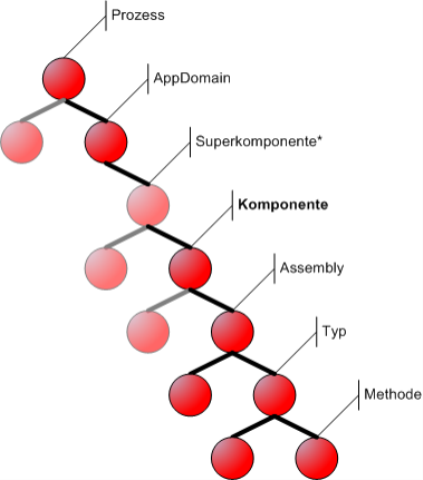
Physische Swolons kann man "sehen und anfassen". Es sind die Artefakte, mit denen Sie täglich umgehen: Klassen, Assemblies usw. Physische Swolon sind das Ergebnis der Implementation von logischen Swolons. Im Gegensatz zu den Modulen ist die Hierarchie der physischen Swolons jedoch vorgegeben. Entwicklungs- und Betriebssystemplattform definieren sie:

Die Hierarchie der physischen Swolons ist wie die der Module durch eine Enthalten-Beziehung definiert: physische Swolons auf einer höheren Ebene enthalten ein oder mehrere physische Swolons der nächst niederen Ebene. In einem Prozess existieren eine oder mehrere AppDomains; in eine AppDomain sind eine oder mehrere Komponenten geladen. Eine Komponente besteht aus einer oder mehreren Assemblies. In einer Assembly sind einer oder mehrere Typen definiert. Ein Typ enthält eine oder mehrere Methoden.

Eine Modulhierarchie kann beliebig tief sein. Eine physische Hierarchie muss jedoch eine wirklich kleinste, unteilbare Einheit als Blatt haben. Das sind für mich Methoden. Sie sind die elementaren physischen Swolons. Alles beginnt bei ihnen als ersten Trägern von Funktionalität.

Einzelne Anweisungen sind für mich keine Swolons, weil sie nicht zu Systemen verbunden werden können. Eine Anweisung kann immer nur zwischen zwei anderen stehen. Methoden können jedoch von beliebig vielen anderen genutzt werden. Sie sind echte Einheiten der Wiederbenutzung.

Das größe physische Swolon ist für mich derzeit ein Prozess. Er ist eine auf Betriebssystemebene klar identifizierbare Codeeinheit.

Zwischen Prozess und Methode ist die physische Swolarchie aufgespannt. Jede Ebene sieht dabei jedoch anders aus. Waren Module auf allen Ebenen der logischen Hierarchie grundsätzlich gleich, so sind physische Swolons auf allen Ebenen grundsätzlich unterschiedlich:

Methoden sind zur Laufzeit nach außen hin reine Funktionalitätsträger und enthalten selbst keinen Zustand, der einen Aufruf überdauert. (Von den früheren statischen Variablen in Methoden bei VB sehe ich an dieser Stelle einmal ab. Es gibt sie aus gutem Grund nicht mehr.)

Typen (oder weniger allgemein: Klassen) sind heute die wesentlichen Träger von Funktionalität und Zustand. Ihre Felder enthalten den Zustand, ihre Methoden definieren ihre Funktionalität. Wenn von physischen Swolons die Rede ist, dann allermeistens von ihnen.

Assemblies fassen Typen zu größeren Funktionseinheiten zusammen und sind die erste Ebene, auf physische Swolons als binäre Black Boxes betrachtet werden können. Innerhalb eines Prozesses ist eine Assembly ein Singleton; ihre Typen können jedoch grundsätzlich beliebig oft instanziert werden. Assemblies können - anders als Typen und Methoden - Teil mehrerer übergeordneter physischer Swolons sein.

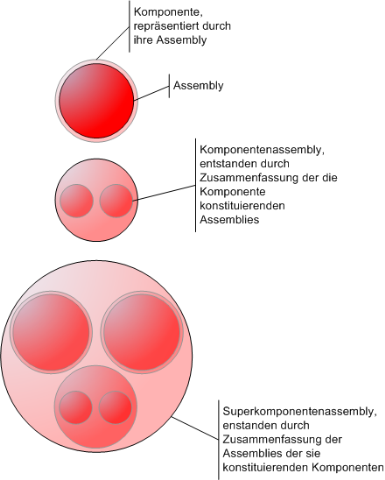
Komponenten sind für mich die zentralen Bausteine für Software. Sind sind ebenfalls binäre Black Boxes und bestehen aus mindestens einer, gelegentlich aber auch aus mehreren Assemblies. Die Komponenten einer Software zu identifizieren ist für mich erstes Ziel der Modellierung. Zu ihnen wird noch einiges zu sagen sein. Wenn Komponenten aus mehreren Assemblies bestehen sollten, dann plädiere ich für ihre Zusammenfassung zu einer neuen Komponentenassembly.

Falls die Zahl der Komponenten einer Software unhandlich groß ist, können sie zu Superkomponenten zusammengefasst werden. Das sind für mich Vereinigungen von mehreren Komponentenassemblies zu einer wiederum größeren Superkomponenteassembly. Dieselbe Komponente kann in mehreren Superkomponenten vorkommen. Komponenten sind für mich unverzichtbare Bauteile von Software, Superkomponenten jedoch sind eine optionale Ebene in der physischen Swolarchie. Allerdings sind sie die einzigen physischen Swolons, die rekursiv definiert sind: Superkomponenten können nicht nur Komponenten, sondern auch andere Superkomponenten enthalten. (Es ließe sich argumentieren, dass Superkomponenten dann überflüssig sind, weil doch auch Komponenten rekursiv definiert werden könnten. Im Augenblick scheint mir die Trennung von Superkomponente und Komponente jedoch vorteilhaft, weil Komponenten für mich die zentralen physischen Bausteine von Software sind. Diese ihre Funktion würde ich ungern durch Rekursivität verwässern.)

Ob am Ende eine Komponente, zu der mehrere Assemblies gehören, oder eine Superkomponente bestehend aus mehreren Komponenten wirklich durch nur eine Assembly repräsentiert wird oder nicht, ist mir allerdings weniger wichtig als die Identifikation ihrer physischen Funktionseinheiten. Eine (Super)Komponente bestehend aus mehreren Assemblies kann von mir aus auch durch ein Verzeichnis oder eine ZIP-Datei physisch klar erkennbar von anderen separiert sein.

Dass Managed Code immer in einer AppDomain abläuft, ist für ihn meist unwichtig. Es gibt jedoch Fälle, in denen Komponenten bewusst auf mehrere AppDomains verteilt werden (z.B. Hauptprogramm und Plug-Ins). AppDomains sollten daher in der physischen Swolarchie sichtbar sein. Auch wenn ein Prozess nur die default AppDomain enthält, so ist sie es doch, in die die Komponentenassemblies geladen werden. Aber auch im Hinblick auf die Kommunikation auf dieser physischen Swolarchieebene ist eine Unterscheidung von den darunterliegenden Ebenen wichtig. Doch dazu später mehr.

Die oberste Ebene der Swolarchie bildet schließlich der Prozess, in dem eine oder mehrere AppDomains liegen. Er spannt den physikalischen Addressraum auf, die AppDomains teilen ihn in logische Unteradressräume auf, über die die CLR wacht. Ein Prozess wird durch eine ausführbare EXE gestartet, die ich den Host nennen. Ob der Host durch Sie geschrieben wird oder schon existiert, ist unerheblich. Wichtig ist, dass ein Prozess einen Ort definiert, an dem kleinere physische Swolons zusammengeführt und ausgeführt werden.

Prozess und AppDomain sind binäre physische Swolons, die eigentlich erst zur Laufzeit existieren. Dennoch sollten sie geplant werden, d.h. zur Entwicklungszeit modellierbar sein. Superkomponente, Komponente und Assembly sind binäre physische Swolons und für mich die wesentlichen Black-Box-Bausteine für Software. Typen und Methoden sind die White-Box-Bausteine und die, über die am meisten diskutiert wird. So wichtig sie natürlich sind, ich halte die Aufmerksamkeit, die sie während der Modellierung bekommen, für unangemessen groß. Oder umgekehrt: Ich denke, die über ihnen liegenden Ebenen der physischen Swolarchie erhalten bisher zuwenig Aufmerksamkeit. Das möchte ich durch diese Darstellung ändern. Denn zusätzliche Ebenen helfen, besser mit der Komplexität von Software umzugehen und machen es einfacher, die Verbindungen zwischen Swolons zu planen. Außerdem sind die über den Typen liegenden physischen Swolons wichtig für das Deployment und das Laufzeitverhalten einer Software.

Software als System VII - Logische Strukturierung

Swolons mit ihrer Funktionalität und ihren Zuständen lassen sich in zwei Arten einteilen: logische und physische Swolons.

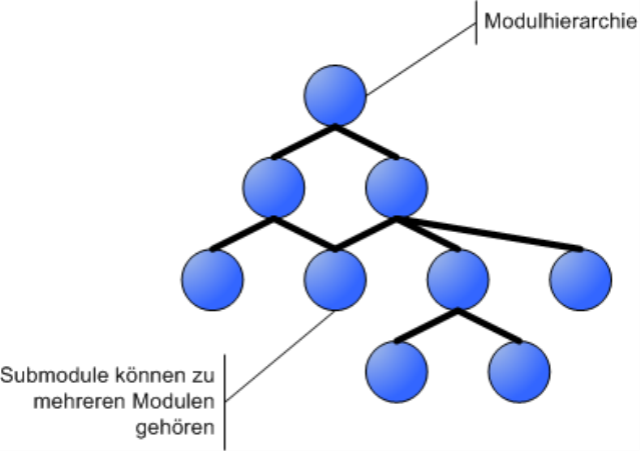
Logische Swolons haben keine bzw. nicht notwendig eine Entsprechung "in der Codewelt". Sie sind lediglich Hilfskonstrukte zur Gliederung einer Software. Ich nenne sie mal Module, weil der Begriff nur relativ wenig besetzt ist. Jede Software kann dann als Hierarchie von Modulen beschrieben werden. Jedes Modul kann aus beliebig vielen Submodulen bestehen. Dasselbe Submodul kann in mehreren Modulen enthalten sein.

Jedes Modul hat eine möglichst klare Aufgabe und entsteht im Prozess einer schrittweisen Dekomposition oder Verfeinerung. Das Wurzelmodul ist die zu entwickelnde Lösung; sie wird in Funktions- oder Verantwortlichkeitsbereiche zerlegt. Diese Module werden dann wiederum in kleinere Funktions- oder Verantwortlichkeitsbereiche zerlegt und so weiter...

Diese Art der Zerlegung eines Systems in immer kleinere Bestandteile ist im Laufe der letzten Jahre leider in Verruf geraten, nicht agil genug zu sein. Dieser grundsätzlichen Kritik kann ich jedoch nicht folgen. Agilität ergibt sich nicht einfach aus dem Verzicht auf eine hierarchische Strukturierung/Planung von Software. Sie ist vielmehr eine Frage des Umgangs mit ihr. Und das ist eine Frage des Entwicklungsprozesses - den ich an dieser Stelle jedoch zunächst ausklammern möchte.

Unabhängig vom Prozess halte ich es für unabdingbar, auch ein Softwaresystem (wie jedes andere komplexe System) sauber in logische Bestandteile zu zerlegen. Die Zerlegungstiefe soll dabei problemangemessen sein. Ziel ist es, schrittweise zu Funktionseinheiten zu kommen, deren Aufgabe klar und überschaubar ist, die einen abschätzbaren Implementationsaufwand haben.

Dabei ist ganz wichtig zu beachten, dass Module eben keine Klassen sind. Module sind logische Swolons, Klassen physische. Die logische Dekomposition findet also losgelöst von einer konkreten Implementierung und Entwicklungsplattform statt. Leitmotiv sollte dabei lediglich sein, Kompliziertes in Einfacheres zu zerlegen. Da Software immer eine Funktion hat, sind Module für mich daher immer zuerst Funktionsträger. Sie stehen für eine möglichst klar umrissene Dienstleistung. Sie sind verantwortlich für ihre Erbringung. Diese Dienstleistung kann natürlich mal mehr funktionsorientiert und mal mehr zustandsorientiert sein.

Jede Ebene im Modulbaum kann auch als Abstraktionsebene angesehen werden. Die Dienstleistung der Module in einer Ebene sollten dann in Bezug auf diese Ebene möglichst klar umrissen sein. Konjunktionen wie "und" und "oder" sollten in Funktionsbeschreibungen nicht vorkommen. Die Summe der Funktionen aller Submodule entspricht dann wieder der Gesamtfunktionalität ihres Moduls.

In Bezug auf seine Submodule ist die Dienstleistung eines Moduls jedoch eher grob und unscharf. Die Submodule präzisieren sie. Ein Beispiel:

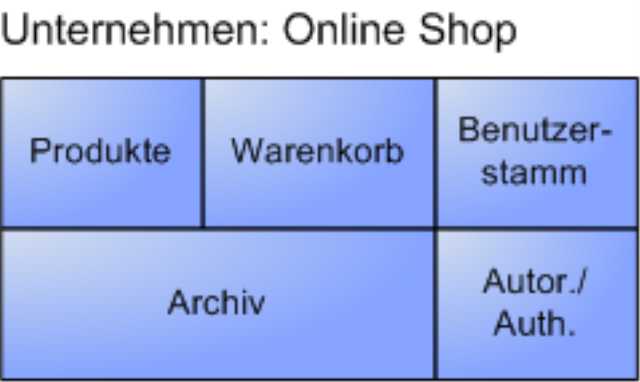
Auf der obersten Abstraktionsebene geht es nur um einen online Shop. Die Ebene darunter präzisiert: zu einem online Shop gehören Produkte, Bestellungen dieser Produkte und die Wahrung der Sicherheit des Bestellvorgangs. Und was genau bedeutet "Wahrung der Sicherheit"? Das präzisiert die darunterliegende Abstraktionsebene. Laut ihr gehören eine Benutzerverwaltung und die Authentifizierung bzw. Autorisierung von Benutzern dazu.

Die Modularisierung einer Software ist sozusagen eine sich schrittweise in das Problem hineingrabende Bestandsaufnahme der Verantwortungsbereiche oder "Abteilungen", die nötig sind, um am Ende einen Nutzen für den Anwender herzustellen. Software kann in diesem Sinn auch als Unternehmen oder Fabrik - software as a factory - angesehen werden: Ihre Produkte sind Dienstleistungen für den Anwender. Der wünscht sich z.B. die Aufnahme eines Artikels in den Warenkorb und die Software erfüllt ihm diesen Wunsch. Oder der Anwender "bestellt" die Umsetzung einer Verkaufszahlenliste in eine Grafik und die Software produziert diese Grafik.

Geleistet werden solches Services von, hergestellt werden solche Produkte durch das Zusammenspiel vieler Swolons mit sehr unterschiedlichen Verantwortlichkeiten und auf unterschiedlichen Abstraktionsebenen. Blätter des vorstehenden Modulbaumes können daher auch als Aufgabenbereiche zu einem "Unternehmen" zusammengesetzt werden:

Eine Modulhierarchie kann insofern auch als Orga-Diagramm angesehen werden. Und die Knoten darin sind Rollen. Damit bewegt sich die logische Strukturierung in der Nähe von OORAM - Object Oriented Role Analysis Method -, verzichtet aber auf die Bindung an ein Implementationsdetail wie Objekte. Während Modularisierung geht also eher und allgemeiner um eine Swolon Rollenanalyse.

Module sind auf allen Ebenen der Modulhierarchie gleich. Es sind Swolons mit den grundsätzlich gleichen allgemeinen Eigenschaften. Auf höheren Ebene sind die Module nur sozusagen größer, weil sie noch Submodule enthalten.

Wann sollten Sie mit der logischen Dekomposition aufhören? Wenn es Ihnen in den Fingern kribbelt und Sie mit der Implementation eines Moduls beginnen wollen. D.h. wenn Sie meinen, Sie würden die Dienstleistung eines Moduls hinlänglich gut überblicken und keine weitere Zerlegung in Submodule benötigen. Implementiert, d.h. in Code gegossen, werden also die Blätter des Modulbaumes. Die Tiefe, in der diese Blätter unter der Wurzel hängen, kann von Ast zu Ast natürlich verschieden sein.